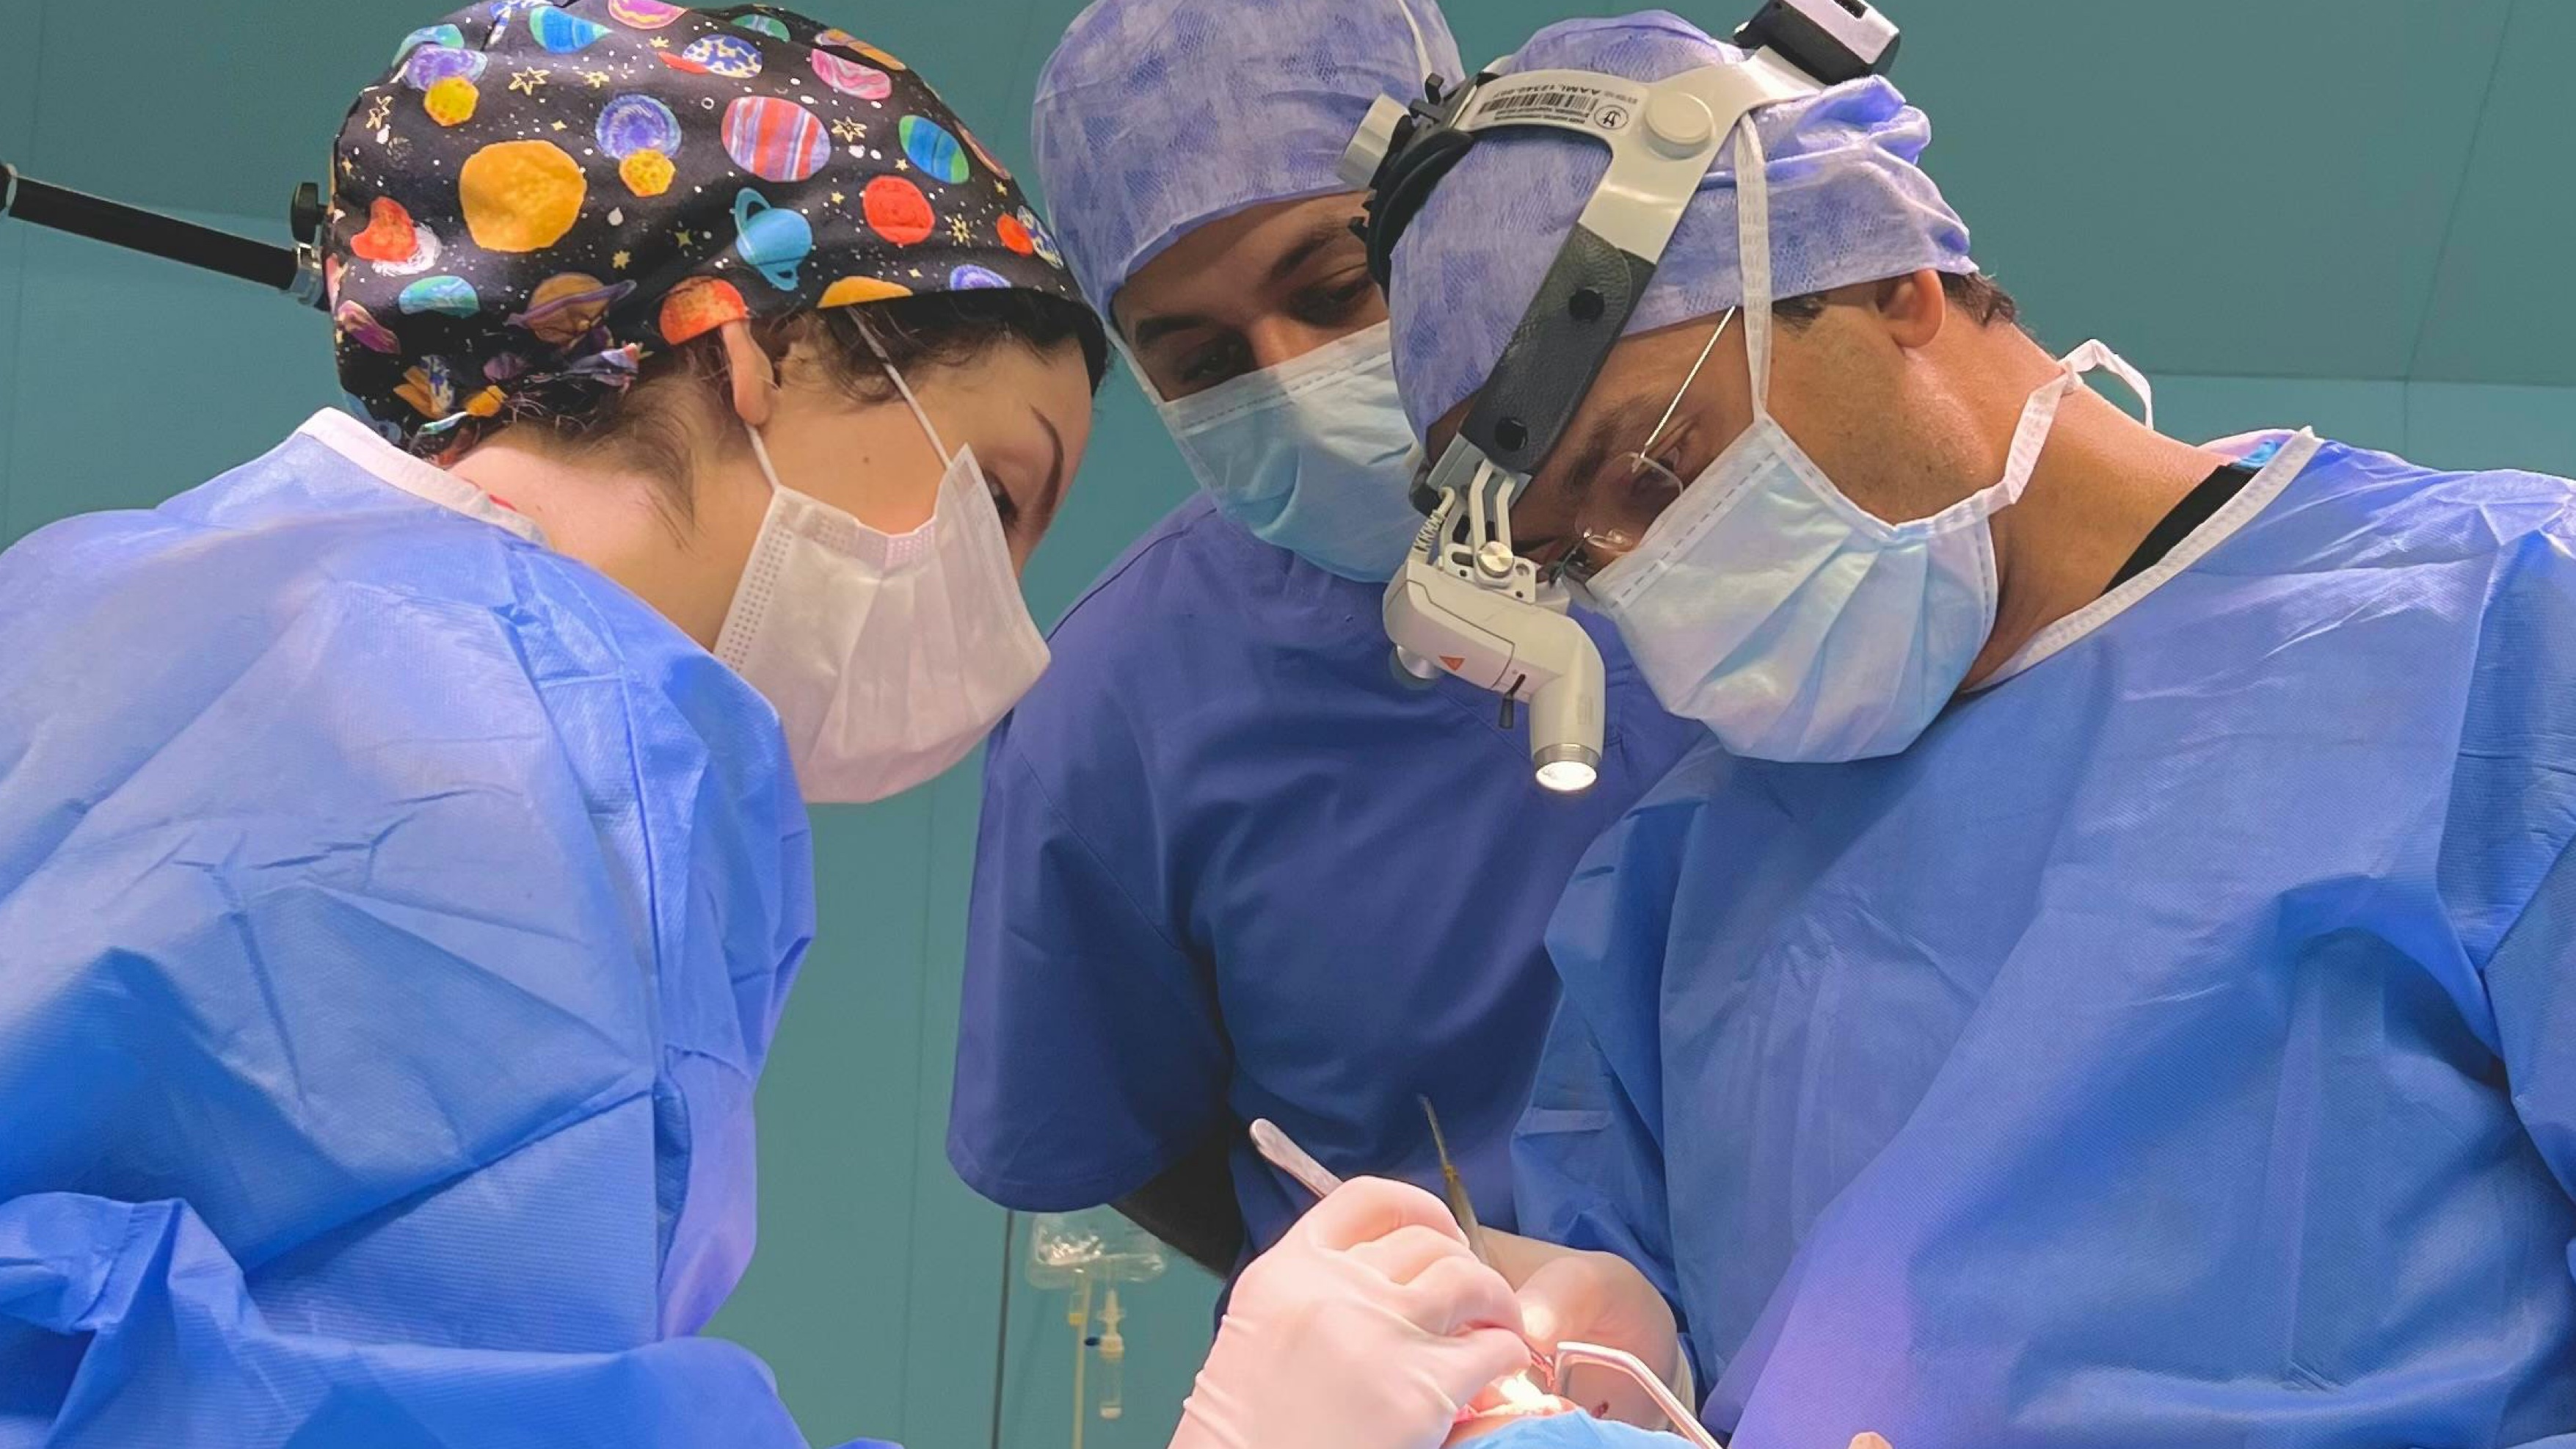
يمكن لنظم الذكاء الاصطناعي الآن أن تتفوق على أطباء قسم الطوارئ في تشخيص المرضى أثناء الفرز، وهي التقييم الأولي الحاسم عند وصول المريض إلى المستشفى. أجريت الأبحاث التي نُشرت في مجلة ساينس باختبار نموذج لغة كبير (LLM)، وهو نفس التقنية التي تدعم ChatGPT، باستخدام ملاحظات سريرية فعلية من قسم طوارئ في بوسطن. في الفرز، حيث تكون المعلومات نادرة جداً والمخاطر عالية جداً، حدد الذكاء الاصطناعي التشخيص أو شيئاً مرتبطاً به بشكل صحيح بنسبة 67% من الحالات. تمكن الطبيبان المقارنان من الوصول إلى 50% و55% فقط. هذه الفجوة تهم للغاية عندما يكون لعدم اكتشاف حالة خطيرة عواقب قد تكون مميتة. تمثل الدراسة قفزة هائلة عن الأبحاث السابقة بشأن الذكاء الاصطناعي التي ركزت على اجتياز الامتحانات الطبية، وهي حيل رائعة لكنها لم تقل شيئاً عن الفائدة السريرية الحقيقية في العالم الواقعي. هذه المرة، استخدم الباحثون سجلات المرضى الحقيقية عبر نقاط قرار متعددة في رعاية الطوارئ، مما يجعل النتائج ذات صلة مباشرة بالممارسة الطبية الفعلية. الرسالة واضحة: يمكن لهذه الأنظمة أن تساعد الأطباء في التفكير في التشخيصات التفاضلية الأوسع، خاصة عندما تكون الأولوية ألا يتم التغاضي عن شيء كارثي. لكن قيود الدراسة مهمة بنفس القدر. عمل الذكاء الاصطناعي بالكامل من النص المكتوب. لم ير وجه المريض قط، لم يلاحظ ضيق التنفس أو العلامات الدقيقة للإنتان، لم يقم بفحصهم جسديًا، لم يتحدث مع أفراد الأسرة القلقين، ولم يتحمل المسؤولية عما سيحدث بعد ذلك. كان يقدم التعرف على الأنماط بشكل متطور على نص منسق، وليس ممارسة طب الطوارئ في الفوضى الواقعية لقسم مزدحم في الساعة 3 صباحًا في يوم سبت. هناك أيضًا فجوة بين إنتاج اقتراحات تشخيصية دقيقة وبين تحسين نتائج المرضى فعليًا. قد تدفع قائمة أطول من الاحتمالات إلى التفكير المفيد، لكنها يمكن أن تؤدي أيضًا إلى سلسلة من الفحوص غير الضرورية، والعلاج المبالغ فيه، وإجهاد الأطباء، أو الثقة المفرطة في إجابة تبدو منطقية لكنها تتحول إلى خطأ كارثي. قد تكون بعض الحالات المؤشر المستخدمة في مثل هذه الدراسات موجودة بالفعل في بيانات تدريب الذكاء الاصطناعي، على الرغم من أن هذا لا يبطل النتائج التي توصل إليها قسم الطوارئ. المشكلة الأكثر إلحاحًا هي أن الممارسة السريرية قد تجاوزت بالفعل الحوكمة. وجدت دراسة مسحية لكلية الأطباء الملكية أن 16% من الأطباء في المملكة المتحدة يستخدمون أدوات الذكاء الاصطناعي في الممارسة السريرية كل يوم، و 15% آخرون يستخدمونها أسبوعياً. وهذا يعني أن ما يقرب من ثلث الأطباء يدمجون هذه الأنظمة في سير عملهم قبل أن تحدد المستشفيات أو الخدمات الصحية الوطنية أو الجهات التنظيمية البروتوكولات لاختبارها، أو تدريب الموظفين لاستخدامها بأمان، أو اكتشاف متى تسبب الضرر، أو تحديد المسؤولية عند حدوث مشكلات. التكنولوجيا مدمجة بالفعل في رعاية المرضى، وتعمل في فراغ تنظيمي.
 ❤️ health
الذكاء الاصطناعي يتفوق على الأطباء في الفرز، ولا أحد يعرف من المسؤول
أظهرت دراسة جديدة نُشرت في مجلة ساينس أن الذكاء الاصطناعي يشخص المرضى في حالات الطوارئ بدقة أكبر من الأطباء في مرحلة الفرز الحرجة - بنسبة 67% مقابل 50-55%. يبدو هذا مثيرًا للإعجاب حتى تدرك أن آلاف الأطباء في المملكة المتحدة يستخدمون هذه الأدوات يوميًا، ولم يتمكن أي شخص من تحديد الحوكمة أو المسؤولية أو بروتوكولات السلامة بشكل صحيح. التكنولوجيا تقدمت بسرعة كبيرة قبل وضع القيود المناسبة.
رأيي
العنوان 'الذكاء الاصطناعي يتفوق على الأطباء' يفوته الهدف تمامًا. المسألة ليست حول ما إذا كان الذكاء الاصطناعي يمكن أن يتفوق على البشر في مهام تشخيصية معينة. لقد مرت تلك السفينة. الفضيحة الحقيقية هي أننا ننزلق ببطء نحو الاستخدام السريري الواسع لأنظمة قوية لم نكتشف أحد كيف نسيطر عليها بشكل صحيح. القول بأن 'يبقى الإنسان في الحلقة' هو كلام مريح بلا مضمون. أي إنسان؟ بأي تدريب؟ بسلطة تجاوز الذكاء الاصطناعي بناءً على أي معايير؟ عندما يبدأ الأداة بالفشل بهدوء، وجميع الأنظمة المعقدة في نهاية المطاف تفشل، من يلاحظ ذلك، ومن يصلحه، ومن يكون مسؤولًا بشكل قانوني؟ هذه ليست أسئلة افتراضية. ستة عشر من الأطباء في المملكة المتحدة يستخدمون الذكاء الاصطناعي يوميًا الآن، في نظام حيث تظل هذه الأسئلة دون إجابة. الطريق الصحيح إلى الأمام ليس حظر هذه الأدوات أو التظاهر بأنها لا توجد. إنه طلب تجارب صارمة في العالم الواقعي، وجعلها دعمًا للرأي الثاني بدلاً من أن تكون صانعي القرار، وقياس ما يهم المرضى فعليًا، وبناء هياكل الحوكمة قبل، وليس بعد، الاعتماد الواسع. بدلاً من ذلك، نقوم بالعكس: الانتشار أولاً، طرح الأسئلة لاحقًا، والأمل في ألا يتأذى أحد في الفجوة.
ماذا سيحدث بعد ذلك
في غضون ستة أشهر، نتوقع أول حادث خطير يرتبط بأدوات التشخيص بالذكاء الاصطناعي في مستشفى في المملكة المتحدة، ليس لأن التكنولوجيا معطوبة بشكل أساسي، ولكن لأن البنية التحتية للحوكمة غير موجودة لالتقاط الإخفاقات المتوقعة. سيُصاب مريض بالأذى من خلال الاختبارات المفرطة التي أُطلقت بسبب تشخيصات تفرقية مولدة من الذكاء الاصطناعي، أو بسبب تشخيص مفقود لأن طبيبًا صغيرًا اعتمد بشدة على خوارزمية ذات ثقة مرتفعة، وفجأة ستنتقل مسألة المسؤولية من المجلات الأكاديمية إلى المحاكم. سوف تستجيب الخدمات الصحية الوطنية بإصدار توجيهات بدلاً من الحوكمة الحقيقية، ربما شكل من 'يظل الأطباء مسؤولين عن جميع القرارات' الذي لا يحل شيئاً ولا يحمي أحدًا. في غضون ذلك، ستواصل الشركات التجارية للبائعين للذكاء الاصطناعي البيع في هذا الفراغ التنظيمي، لأنه لا يوجد آلية إنفاذ لوقفها. بعض المستشفيات ستتراجع بهدوء عن أدوات الذكاء الاصطناعي بعد الدعوى الأولى، بينما سيضاعف البعض الآخر استخدامها، مما سيخلق يانصيبًا لنشر الذكاء الاصطناعي عبر البلاد. السيناريو الجدي الممتع هو إذا تدخلت الكليات الملكية قبل المنظمين وأقامت نظام اعتماد خاص بها يهدف إلى مراجعة الأقران لأدوات الذكاء الاصطناعي السريرية. سيكون الأمر معقدًا وغير كامل، ولكنه قد يخلق بالفعل المساءلة بسرعة أكبر من الانتظار لاتخاذ إجراءات حكومية. البديل هو سنوات من التنظيم التفاعلي المكتوب استجابة للمآسي الممكن تجنبها، وهو عادة الطريقة التي تتعامل بها المملكة المتحدة مع التكنولوجيا الناشئة في الرعاية الصحية.
ما يخبرنا به التاريخ
هذا الفجوة في الحوكمة لها أمثلة تاريخية دقيقة مع إدخال أجهزة التصوير المقطعي المحوسب (CT) في السبعينيات. كانت التكنولوجيا ثورية، حسنت دقة التشخيص، واعتمدت بسرعة في جميع المستشفيات قبل أن يضع أي شخص بروتوكولات للاستخدام المناسب أو حدود التعرض للإشعاع أو معايير تدريب الأطباء. كانت النتيجة سنوات من الإفراط في الاستخدام، والتعرض غير الضروري للإشعاع، والاعتراف النهائي بأن الأدوات التشخيصية القوية تتطلب حوكمة نظامية، وليس مجرد حماس سريري. استغرق الأمر من الهيئات التنظيمية تقريبًا عقدًا من الزمن لتواكب التكنولوجيا التي كانت متوغلة بالفعل في الممارسة اليومية. الوضع مع الذكاء الاصطناعي يتحرك بشكل أسرع وقد يحمل مخاطر أعلى، لأن أجهزة التصوير المقطعي المحوسب كانت أدوات تدار بواسطة الأطباء مع مسؤولية واضحة، بينما تقدم نظم الذكاء الاصطناعي توصيات مستقلة يمكنها تغيير القرارات السريرية بطريقة غير مرئية بدون خطوط مسؤولية واضحة. نحن نكرر نفس الخطأ بسرعة أكبر.