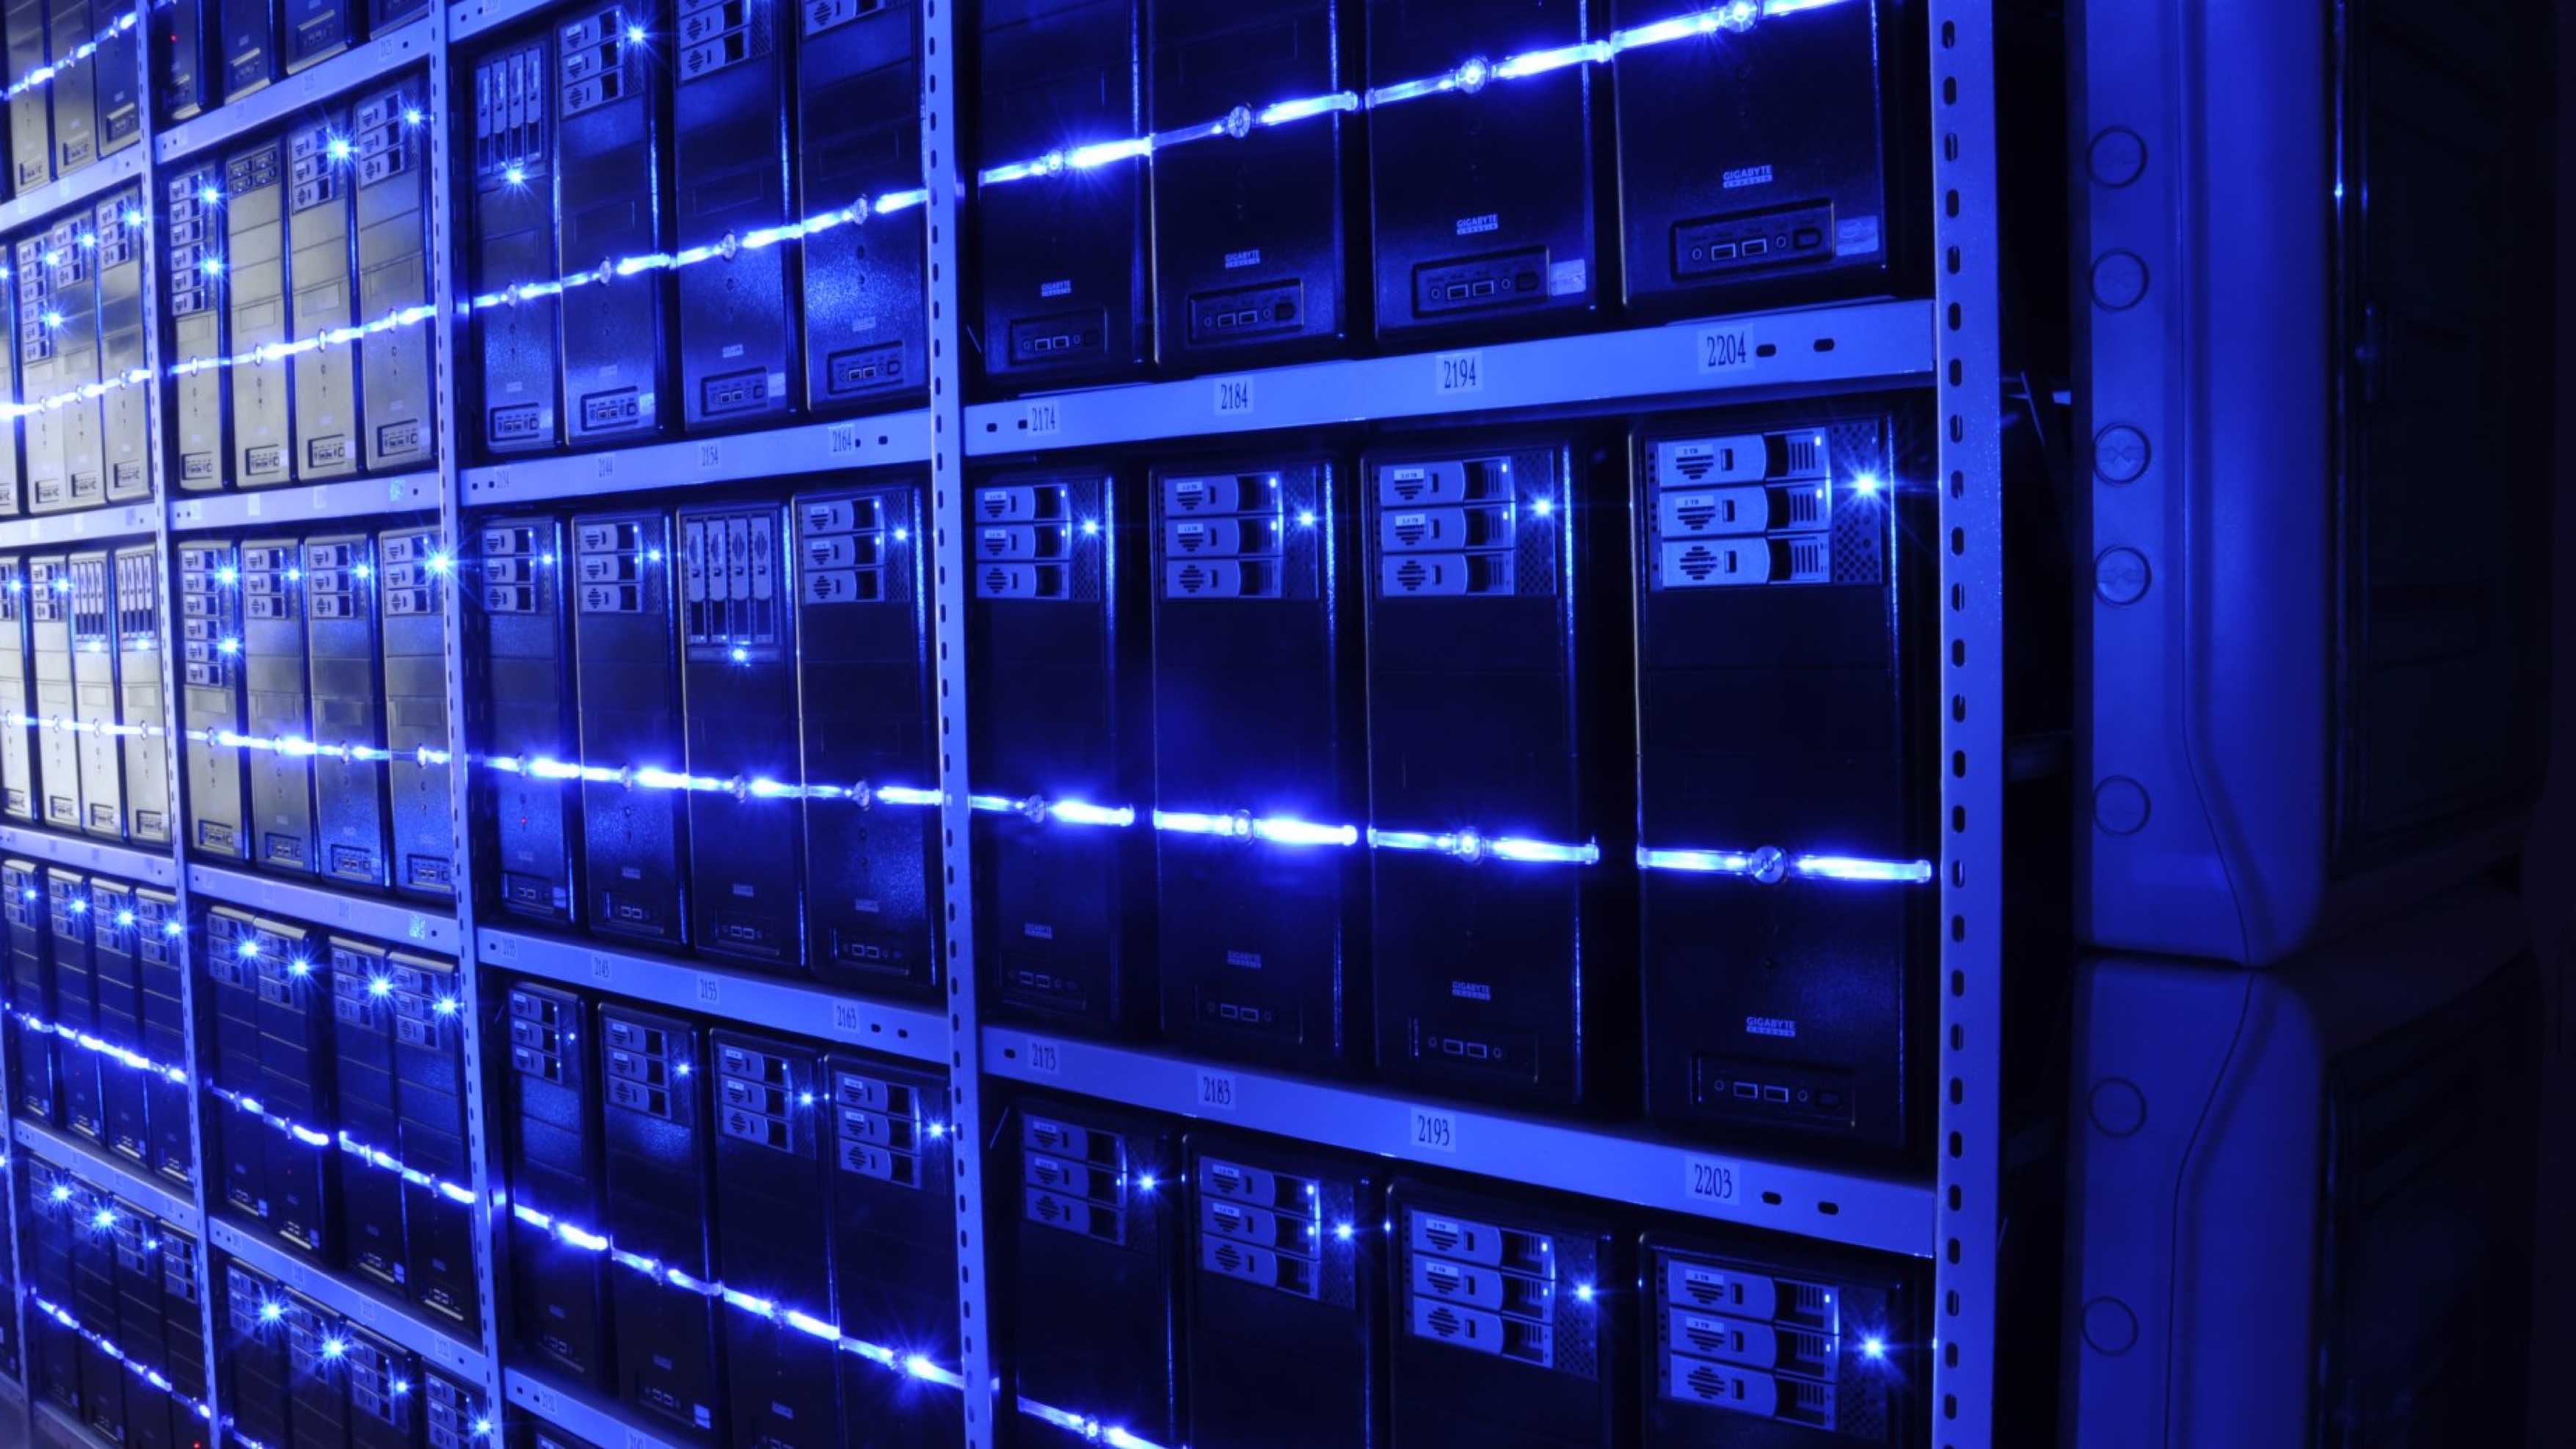
دعونا نبدأ بما يحدث فعليًا عندما تسأل ChatGPT سؤالًا. يؤدي طلبك البسيط إلى تفعيل مليارات العمليات الرياضية عبر آلاف الرقائق المتخصصة المسماة وحدات معالجة الرسومات (GPUs). لا تقوم هذه الرقائق فقط بتخزين نموذج الذكاء الاصطناعي، بل تقوم فعليًا بحساب الاحتمالات لكل كلمة محتملة تالية، وتربط الأنماط بالبيانات التدريبية التي تمثل أجزاء من الإنترنت بالكامل، وتحسن التوقعات من خلال طبقات الشبكات العصبية. كل طبقة تضيف وزنًا حسابيًا. يُقال إن GPT 4 يحتوي على أكثر من تريليون معلمة، فكر في هذه المعلمات كحوامل يضبطها الذكاء الاصطناعي لإنتاج استجابات متماسكة. كل حامل يحتاج إلى طاقة للعمل. قبل حدوث أي من ذلك، يمر طلبك بعملية تسمى التجزئة. عندما تكتب "كيف يتم تصميم LLMs؟" في ChatGPT، لا يرسل متصفحك تلك النص الخام إلى خوادم OpenAI. بدلاً من ذلك، يقوم برنامج جافا سكريبت الذي يعمل على جهاز الكمبيوتر المحلي الخاص بك بتقسيم الجملة إلى رموز، وهي قطع نصية يفهمها النموذج. قد يكون الرمز كلمة كاملة مثل "كيف" أو جزء من كلمة مثل "تصميم" و"ed" مفصولًا. يقوم المجزّئ بتحويل جملتك إلى سلسلة من الأرقام، كل منها يمثل رمزًا معينًا من مفردات النموذج (عادةً 50000 إلى 100000 رمز ممكن). هذه الأرقام، وليس نصك الأصلي، هي ما يتم نقله إلى مركز البيانات. يحدث هذا على الفور، في غضون ميلي ثانية، ويستخدم القليل من الطاقة على جهازك. بمجرد وصول طلبك المجزّأ إلى مركز البيانات، يصيب موزع الأحمال، وهو جهاز كمبيوتر متخصص يقرر أي خادم يجب أن يتعامل مع طلبك. تقوم شركات الذكاء الاصطناعي الكبرى بتشغيل مراكز بيانات متعددة عبر قارات مختلفة، لذا قد يتم توجيه طلبك إلى فرجينيا أو أوريغون أو أيرلندا أو سنغافورة بناءً على القرب الجغرافي والتحميل الحالي للخوادم. وظيفة موزع الأحمال هي منع انغمار أي آلة واحدة بينما تبقى الأخرى خاملة. يقوم بتتبع الخوادم المزدحمة، والتي لديها السعة، ويوزع الطلبات الواردة بناءً على ذلك. يحدث قرار التوجيه هذا في ميكروثانية. ثم يتم تخصيص طلبك إلى خادم استدلال محدد، والذي قد يكون آلة مادية واحدة تحتوي على 8 وحدات معالجة رسومات GPU، أو على الأرجح، مجموعة من الآلات التي تعمل معًا. هنا حيث تنفجر التعقيد. النموذج الذكاء الاصطناعي كبير جدًا ليلائم وحدة معالجة رسومات واحدة. تتطلب أكثر من تريليون معلمة من GPT 4 مئات من الجيجابايت من الذاكرة. تحتوي وحدة معالجة الرسومات H100 الفردية على 80 جيجابايت من الذاكرة ذات النطاق الترددي العالي (HBM). لذا يتم تقسيم النموذج عبر وحدات معالجة الرسومات المتعددة باستخدام تقنية تسمى النموذج التوازي. تعيش طبقات مختلفة من الشبكة العصبية على رقائق مختلفة. عند معالجة طلبك، يجب أن تتحدث وحدات معالجة الرسومات باستمرار مع بعضها البعض، وتمرر النتائج الوسيطة من طبقة إلى أخرى. تتواصل وحدات معالجة الرسومات هذه من خلال تداخلات عالية السرعة متخصصة، وليست الإيثرنت العادية. تسمح تقنية NVLink من NVIDIA لوحدات معالجة الرسومات في نفس الخادم بنقل البيانات بسرعة 900 جيجابايت في الثانية، تقريبا 10 أضعاف سرعة أسرع محركات الأقراص SSD للمستهلكين. بالنسبة لوحدات معالجة الرسومات في الخوادم المختلفة، تستخدم مراكز البيانات شبكات InfiniBand، التي توفر سرعات مماثلة مع وقت تأخير منخفض جدًا (نطاق الميكرو ثانية). يهم هذا بشكل كبير لأن نموذج الذكاء الاصطناعي يعالج طلبك بالتتابع، رمزًا واحدًا في المرة. تقوم وحدة معالجة الرسومات الأولى بمعالجة حسابات الطبقة الأولى، وترسل النتائج إلى وحدة معالجة الرسومات الثانية للطبقة الثانية، وهكذا عبر 96 طبقة أو أكثر. يصبح أي تأخير في الاتصالات عنق زجاجة يبطئ وقت الاستجابة. هنا الجزء الذي لا يدركه معظم الناس: تلك وحدات معالجة الرسومات ليست تقسم فقط طلبك. إنهم يعالجون عشرات أو مئات في نفس الوقت عبر تقنية تسمى التراص. يقوم الخادم بتجميع الطلبات من المستخدمين المختلفين التي وصلت في نفس الوقت تقريبًا، ويعالجها بشكل متواز على نفس النوى لوحدات المعالجة الرسومية، ثم يقسم النتائج للخارج. هذا يحسن الكفاءة بشكل كبير. تقوم وحدة معالجة الرسومات بحساب استجابة واحدة في كل مرة تضيع معظم نوى معالجتها. يحافظ تجميع عدة طلبات معًا على انشغال جميع النوى. ومع ذلك، فإن التراص يقدم تعقيدًا في الاتصال بين وحدات المعالجة الرسومية. يجب أن تبقى نتائج المستخدمين المختلفة منفصلة، مما يتطلب إدارة ذاكرة إضافية وتوجيه بيانات دقيق. الواقع الفيزيائي للحساب ينشئ مشكلة لا مفر منها: الكهرباء تتحول إلى حرارة. تستهلك الرقائق الحديثة للذكاء الاصطناعي مثل وحدات معالجة الرسومات H100 من NVIDIA 700 واط لكل منها تحت الحمل الكامل، وهو ما يعادل سبع لمبات متلألئة قديمة تعمل في وقت واحد. ولكن مراكز البيانات لا تحتوي على سبع وحدات معالجة رسومية فقط. تحتوي على آلاف أو عشرات الآلاف. يستخدم مركز الأبحاث الفائق للذكاء الاصطناعي لشركة Meta 16000 وحدة معالجة رسومية. وتفيد التقارير بأن مرافق Microsoft الداعمة لـ OpenAI تستخدم أكثر بكثير. عندما تضاعف 700 واط بـ 20000 وحدة معالجة رسومية، فأنت تنظر إلى 14 ميجاوات فقط للحوسبة، قبل التبريد، أو الشبكات، أو التخزين. هذا يكفي لتشغيل حوالي 10000 منزل أمريكي. يصبح التبريد مصاص الطاقة الخفي. تقوم وحدات معالجة الرسومات هذه بتوليد حرارة هائلة في رفوف خوادم محشوة بإحكام. بدون تبريد شرس، ترتفع حرارة الرقائق وتفشل في غضون دقائق. تستخدم مراكز البيانات تكييف الهواء على نطاق صناعي، وأنظمة التبريد السائل، وأحيانًا التبريد بواسطة التبخير الذي يستهلك ملايين جالونات المياه سنويًا. استخدمت مراكز بيانات Google وحدها 4.3 مليار جالون من الماء في عام 2022. في العادة، يستهلك جزء التبريد بين 30 إلى 40% من الطاقة نفسها من الحوسبة. الفيزياء لا تفاوض. يجب إزالة الحرارة بمعدل إنتاجها، أو تذوب الأجهزة. لماذا لا يمكنهم فقط استخدام نماذج أصغر؟ لأن الأداء يتدهور بشكل كارثي. تشير الأبحاث إلى أن النماذج الأكبر مع مزيد من المعلمات تظهر قدرات ناشئة، وهي قدرات لا يمكن للنماذج الصغيرة ببساطة تكرارها بغض النظر عن وقت التدريب. يقوم GPT 3 مع 175 مليار معلمة بأداء أفضل بكثير من النماذج ذات المليار معلمة في مهام التفكير المعقدة. لا يوجد خدعة كفاءة حول هذا. تريد أن يفهم الذكاء الاصطناعي السياق، ويولد استجابات إبداعية، ويتجنب الإخراج غير المعقول؟ عليك دفع ثمن المعلمات. المزيد من المعلمات تعني المزيد من الحوسبة لكل استعلام، مما يعني المزيد من الطاقة. لكن الأمر لم يكن دائمًا على هذا النحو. كان أول نموذج لغوي كبير صدم الباحثين والجمهور حقًا هو GPT 2، الذي صدر عن OpenAI في فبراير 2019. كان يحتوي النموذج على 1.5 مليار معلمة، وهو صغير بمعايير اليوم، لكن ثوري في زمانه. رفضت OpenAI في البداية الإفراج عن النموذج الكامل، مستشهدة بمخاوف تتعلق بالسلامة حول الاستخدام غير المناسب المحتمل لتوليد الأخبار الزائفة والبريد المزعج. أصبحت تلك القرار نفسه لحظة مفصلية، المرة الأولى التي تدعي فيها مختبر ذكاء اصطناعي علنًا أن تقنيته خطيرة جدًا للمشاركة بحرية. كان العرض التوضيحي GPT 2 الأصلي بسيطًا بشكل ملحوظ ويعمل على أجهزة متواضعة. عرض الباحثون في OpenAI النموذج الذي يرون لفقرة مثل "في اكتشاف صادم، اكتشف العلماء قطيعًا من الأحادي القرن يعيش في وادٍ ناءٍ لم يتم استكشافه من قبل، في جبال الأنديز." ثم استمر النموذج في القصة مع فقرات متماسكة متعددة حول الأحادي القرن، معاطفها البيضاء الفضية، قرونها الفريدة ذات الخصائص العلاجية، وذهول العلماء عند الاكتشاف. يتدفق النص بشكل طبيعي، ويحافظ على تفاصيل متسقة، وحتى يخترع أسماء علماء وأبحاث تبدو معقولة. لم يتمكن القراء في البداية من معرفة أنه كان من صنع الآلة. ما جعل هذا العرض التوضيحي قويًا لم يكن متطلبات الأجهزة، بل كان الاختراق المفاهيمي. أثبت GPT 2 أن نموذجًا واحدًا، مدربًا فقط على التنبؤ بالكلمة التالية في تسلسل، يمكنه أن يفهم بشكل ظاهري هيكل السرد، ويحافظ على السياق عبر مئات الكلمات، ويولد خيالًا إبداعيًا دون أي برمجة محددة للمهمة. كانت الأنظمة الذكاء الصناعي السابقة تحتاج إلى وحدات منفصلة لمهام مختلفة: واحدة للترجمة، وأخرى للتلخيص، وثالثة للإجابة على الأسئلة. قام GPT 2 بعمل كل ذلك مع هيكل واحد، لمجرد تعلم الأنماط في النص. كانت متطلبات الحوسبة لذلك العرض التوضيحي الأول متواضعة بمعايير مركز البيانات. يمكن لـ GPT 2 تشغيل الاستدلال (وهو توليد النص) على وحدة معالجة الرسومات للمستهلكين العاديين، وهو شيء يمكن للباحثين المجهزة جيدا أن يتواجد في محطة عملهم المكتبية. يمكن لـ NVIDIA GTX 1080 Ti مع 11 جيجابايت من الذاكرة التعامل مع أكبر نوع من GPT 2، وتوليد النص عند بضع كلمات في الثانية. كان ملف النموذج نفسه حوالي 6 جيجابايت. يمكنك تنزيله، تحميله إلى الذاكرة، والبدء في توليد النص بدون الحاجة إلى موارد السحابة. كان هذا التسهيل حاسمًا. يستطيع الباحثون في جميع أنحاء العالم تجربة GPT 2، دفع حدودها، واكتشاف كل من قدراتها وفشلها. ومع ذلك، كانت تدريب GPT 2 قصة مختلفة. استخدمت OpenAI 40 جيجابايت من نص الإنترنت وتدربت على مجموعة من الآلات لأسابيع. حتى في عام 2019، تطلب ذلك موارد حسابية كبيرة، ربما تصل إلى مئات الآلاف من الدولارات في تكاليف الحوسبة السحابية. ولكنها كانت ممكنة لمختبر ممول بشكل جيد، ولم تكن بعد مشاريع بعشرات الملايين من الدولارات التي يتطلبها تدريب GPT 4. في وقت لاحق، demonstrated يعرض Andrej Karpathy، المدير السابق للذكاء الاصطناعي في Tesla والباحث في OpenAI، البساطة الأساسية للنماذج اللغوية بمشروع تعليمي يسمى "minGPT." أظهر أنه يمكنك تنفيذ نموذج يعمل بأسلوب GPT في بضع مئات من أسطر شفرة بايثون. الخوارزمية ليست سحرًا، بل هي عمليات تكاثر المصفوفات وآليات الانتباه، وهي عمليات قياسية يمكن لأي طالب دراسات عليا في علوم الكمبيوتر فهمها. ما تغير بين GPT 2 و GPT 4 لم يكن الخوارزمية الأساسية. كان الحجم: المزيد من المعلمات، المزيد من البيانات التدريبية، المزيد من الحوسبة، وبالأخص، المزيد من الطاقة. كان لحظة GPT 2 هي "مرحبًا بالعالم" للذكاء الاصطناعي لأنها أثبتت أن نمذجة اللغة تعمل على نطاق يهم. النماذج السابقة كانت تولد رأيًا نحويًا صحيحًا أو تحفظ بيانات التدريب دون فهم. أظهر GPT 2 شيئًا يشبه الفهم، حتى لو كانت فلسفيًا، كانت مجرد التنبؤ بأنماط إحصائية. أخبر الباحثون GPT 2 بمطالبات باللغة الفرنسية وحصلوا على استجابات فرنسية متماسكة، على الرغم من عدم وجود تدريب صريح على الترجمة. طلبوا منها كتابة قصائد بأساليب معينة وحصلوا على محاولات منطقية. النموذج لم يكن مثاليًا، كان ينحرف في النهاية عن الموضوع أو يتناقض مع نفسه، لكن القدرات كانت غير قابلة للنقاش. استراتيجية الإطلاق المرحلية لـ OpenAI أضافت إلى تأثير GPT 2. أطلقوا أولاً إصدار 124 مليون معلمة أصغر، ثم أطلقوا تدريجيًا أشكالًا أكبر على مدى الأشهر المقبلة حيث أثبتت المجتمع البحثي استخدامًا مسؤولًا. خلق هذا اهتمامًا مستدامًا وأتاح للباحثين الوقت لاكتشاف قدرات كل حجم. بحلول الوقت الذي أطلق فيه الإصدار الكامل 1.5 مليار معلمة في نوفمبر 2019، كان مجتمع الذكاء الاصطناعي قد أمضى تسعة أشهر في اكتشاف ما يمكن أن تفعله النماذج اللغوية الموسعة. جعل هذا الأساس إعلان GPT 3 في يونيو 2020 يبدو كتحول طبيعي بدلاً من صدمة. غير GPT 3 كل شيء لأن OpenAI لم تصدر النموذج لتنزيله. بدلاً من ذلك، عرضوا الوصول إلى API، حيث يرسل المطورون المطالبات إلى خوادم OpenAI ويتلقون اكتمالات. كان هذا التحول حاسمًا لأسباب: لقد حمى ميزة OpenAI التنافسية (لا يمكن لأحد دراسة أو نسخ نموذجهم مباشرة)، وركز متطلبات الحوسبة. فجأة، لم تكن بحاجة إلى وحدة معالجة رسومات لاستخدام GPT 3. كنت تحتاج فقط إلى API ومفتاح و بطاقة ائتمان. هذا وفر الوصول بينما أنشأ اعتمادًا على بنية OpenAI التحتية. يعني نموذج API أيضًا أن المستخدمين لم يروا التكلفة الحقيقية للحوسبة. عندما كنت تشغل GPT 2 على جهازك المحلي، سمعت المراوح تدور، شعرت بالحرارة، وربما لاحظت فاتورة الكهرباء ترتفع إذا شغلتها باستمرار. مع API لـ GPT 3، كانت الحوسبة تحدث بشكل غير مرئي في أحد مراكز البيانات في مكان ما. كنت تدفع لكل رمز، بضعة سنتات لآلاف الكلمات، بدون شعور بالميجاوات المحترقة خلف الكواليس. هذا التجريد هو كيف توسعت الصناعة بسرعة كبيرة دون إثارة مخاوف الطاقة الفورية. التكلفة كانت مخفية في الميزانيات التشغيلية وفواتير المرافق، ليست مرئية للمستخدمين النهائيين. الآن هنا هو التمييز الحاسم الذي يفوته معظم الناس: استخدام نموذج الذكاء الاصطناعي المدرب (الاستدلال) يختلف تمامًا عن تدريب نموذج الذكاء الاصطناعي في المقام الأول. عندما تتحدث مع ChatGPT، فأنت تستخدم نموذجًا تم تدريبه بالفعل. التدريب هو ما حدث قبل شهور، عندما أنشأت OpenAI ذلك النموذج من الصفر. فكر في الأمر مثل الفرق بين قراءة كتاب وكتابة الكتاب. استخدام ChatGPT هو قراءة. التدريب هو العملية الشاقة لكتابة كل كلمة واحدة. يبدأ التدريب بصفحة فارغة، شبكة عصبية ب قيم معلمة عشوائية تنتج نسيجًا كاملاً من الهراء. تخيل مليارات الحوامل جميعها تم ضبطها على مواقف عشوائية. لا تعرف الشبكة أي شيء عن اللغة، النحو، الحقائق، أو التفكير. إنه هُراء رقمي. العملية التدريبية تتعلق بضبط تلك المليارات من الحوامل، بكميات ضئيلة في كل مرة، حتى تبدأ الشبكة بإنتاج نص متماسك. إليك كيفية العمل الفعلي: تُغذي الشبكة بقطعة ضخمة من النص، لنقل مقال من ويكيبيديا عن الدلافين. تحاول الشبكة التنبؤ بالكلمة التالية في جملة. مع معلمات عشوائية، تفشل بشكل مذهل. حيث يقول النص الحقيقي "الدلافين هي الثدييات البحرية الذكية للغاية،" قد تتوقع الشبكة غير المدربة "الدلافين هي السابعة عشر الأرجوانية" لأن معلماتها هراء. يقيس خوارزمية التدريب مدى خطأ ذلك التنبؤ. يُطلق على هذا حساب الفقد. كلما كان التنبؤ أسوأ، كان الرقم الفقدي أعلى. ثم تأتي الخطوة الرئيسية: الانتشار العكسي. تعمل الخوارزمية في الاتجاه المعاكس عبر جميع طبقات الشبكة، وتحسب بالضبط مقدار كيفية مساهمة كل من تلك المليارات من المعلمات في التنبؤ السيئ. إنه مثل المحاسبة الشرعية للشبكات العصبية، تتبع الخطأ إلى مصادره. بمجرد أن تعرف الخوارزمية أي المعلمات تسببت في المشكلة، تقوم بتعديلها قليلاً في الاتجاه الذي كان سيؤدي إلى توقعت أفضل. هذا ما يسمى بالنزول التدريجي. تقوم بالضغط على مليارات الحوامل، كل واحدة بكمية صغيرة، محاولًا الاقتراب قليلاً من الأداء الأفضل. تعديل واحد لا يفعل الكثير. ولكنك تكرر هذه العملية تريليونات من مرات مع تريليونات من الأمثلة النصية المختلفة، وتدريجيًا تتحول تلك الحوامل العشوائية إلى تكوينات تعمل بالفعل. استهلاك الطاقة خلال التدريب مذهل للغاية لأنك تقوم بهذا الحوسبة مرارًا وتكرارًا عبر كل نص الإنترنت. وفقًا للتقارير، تطلب تدريب GPT 3 1,287 ميجاوات ساعة، وهو ما يكافئ ما تستخدمه 120 منزلًا أمريكيًا طوال العام، في أسبوع أو شهور من الحوسبة المستمرة. لا تقوم فقط بقراءة النص. أنت تقوم بحسابات رياضية رباعية: تكاثر المصفوفات، حساب التدرجات، تحديث المعلمات، كل شيء عبر آلاف من وحدات معالجة الرسومات GPU التي تعمل 24/7. إليك لماذا التدريب أكثر تكلفة بكثير من الاستدلال: عندما تستخدم ChatGPT (الاستدلال)، تبقى المعلمات مجمدة. تقوم الشبكة بعملية واحدة تمر عبر طبقاتها، تحسب الاحتمالات، تختار كلمة، وتتحرك. يتطلب التدريب مرورًا للأمام لجعل التنبؤ، ثم مرورًا للخلف لحساب التدرجات، ثم تحديث المعلمات، ثم عمليات التحقق من الصحة، كل ذلك يتكرر بمليارات المرات. أنت تقوم، ربما، بـ 100 ضعف من الحوسبة لكل كلمة خلال التدريب مقارنة بالاستدلال. التدريب الحديث يحدث أيضًا في مراحل متعددة. أولاً، هناك التدريب المسبق، حيث يتعلم النموذج الأنماط اللغوية العامة من مجموعات بيانات ضخمة. هذا هو الجزء المكلف الذي يستهلك 1000+ ميجاوات ساعة. ثم تأتي المرحلة النهائية، حيث تأخذ ذلك النموذج المدرب مسبقًا وتخصصه لمهام محددة مثل اتباع التعليمات أو إجراء المحادثات. تستخدم الترهينات النهائية مجموعات بيانات أصغر وأكثر دقة وتقوم بضبط المعلمات برفق أكثر. لا يزال مكلفًا حاسوبيًا، ولكن ربما يكون بنسبة 1 إلى 10% من تكلفة التدريب المسبق. تقوم الشركات أيضًا بعمليات التعلم المعزز من تغذية راجعة بشرية (RLHF)، حيث يقوم المراقبون البشريون بتصنيف استجابات الذكاء الاصطناعي، وعلى أساس هذه التقييمات، تقوم الخوارزمية التدريبية بتعديل المعلمات لإنتاج استجابات تحصل على درجات أعلى. بعد انتهاء التدريب، تحصل على ملف نموذجي يحتوي على مليارات القيم ثابتة المعلمات. يتم نسخ هذا الملف إلى خوادم الاستدلال في جميع أنحاء العالم. تقوم هذه الخوادم فقط بقراءة المعلمات واستخدامها للإجابة على الأسئلة. لن تعدل المعلمات أبدًا. يبقى النموذج بنفس الذكاء (أو الغباء) كما كان لحظة انتهاء التدريب. استخدام ChatGPT مليار مرة لا يجعله أذكى، لأن الاستدلال لا يقوم بتغيير المعلمات. هذه نقطة حاسمة التي يسيء فهمها الكثير من الناس: لا تتعلم نماذج الذكاء الاصطناعي من المحادثات مع المستخدمين. إنها لقطات ثابتة للمعرفة مجمدة في نهاية عملية التدريب. هذا هو السبب في أن وهم Raspberry Pi لا يعمل. يمكنك تنزيل نموذج مدرب مسبق إلى Pi وتشغيل الاستدلال، ولكن لا يجعل Pi النموذج أذكى من خلال الاستخدام. يتطلب التدريب أجهزة متخصصة، مجموعة بيانات ضخمة، وأشهرًا من الحوسبة التي يمكن أن تستغرق Pi لديك قرونًا لإكمالها. النموذج الذي قمت بتنزيله مجمد في الوقت، وهو لقطة لما تعلمه أثناء التدريب. لماذا يتفوق Claude غالبًا على ChatGPT في مهام الترميز؟ الجواب ليس ببساطة المزيد من البيانات. إنه عن البيانات، وكيف يتم توزينها، وكيف يتم تحسين النموذج بعد التدريب الأولي. قامت Anthropic بتدريب Claude بتقنية تسمى الذكاء الاصطناعي الدستوري (CAI)، والتي تتضمن جولات متعددة من الترقية حيث يقوم الذكاء الاصطناعي بنقد وتعديل مخرجاته بناءً على مبادئ واضحة. بالنسبة للترميز على وجه التحديد، يعني ذلك احتمال رؤية Claude لمزيد من الأمثلة على الشفرات المتنوعة أثناء التدريب، وتلقيه إشارات قوية لإعطاء الأولوية للصحة على الإبداع، وتعرضه لتعلم تعزيز إضافي يمكنه من التعامل مع تحديات البرمجة. تستخدم OpenAI وAnthropic مجموعات تدريب مختلفة مع استراتيجيات ترخيص ومصادر مختلفة. ربما قام Claude بالتغذي على المزيد من مستودعات GitHub، ومناقشات Stack Overflow، والوثائق التقنية. تختلف بنية النموذج أيضًا بشكل طفيف. بينما يستخدم كلاهما تصميمات تعتمد على المحولات، تختلف اختيارات Anthropic حول آليات الانتباه، وتحسين نافذة السياق، وكيفية تعامل النموذج مع النصوص المنظمة مقابل غير المنظمة بشكل كبير على الأداء في المهام التي تتطلب بناء جملة ودقة منطقية دقيقة. مبدأ الجودة فوق الكمية يهم كثيرًا في بيانات التدريب. تغذية نموذج الذكاء الاصطناعي بـ 10 تريليون رمز من نص الإنترنت العشوائي ينتج نتائج أسوأ من 5 تريليونات رمز منتقاة بعناية. بالنسبة لمهام الترميز، يعني ذلك إعطاء الأولوية للمستودعات مع شفرة درجة الإنتاج موثقة جيدًا على الواجبات المنزلية للطلاب المستخرجة من المنتديات. هذا يعني إعطاء وزن أكبر للوثائق الفنية ومرجع API على مقالات المدونات العرضية حول الترميز. بالتأكيد spend أنثروبيا جهدًا هندسيًا كبيرًا في تصفية بيانات التدريب للحصول على تميز في الترميز، بينما قامت OpenAI بتحسين GPT 4 بشكل أوسع عبر القابلية للمحادثات، والكتابة الإبداعية، والمعرفة العامة. لا يوجد نهج خاطئ، ولكنهم ينتجون نماذج ذات نقاط قوة مختلفة. هل يوجد سقف لتعلم الذكاء الاصطناعي، أم يمكن للنماذج أن تستمر في التحسن إلى الأبد؟ الإجابة الصادقة: لا نعرف بعد، لكن الأدلة تشير إلى أننا نقترب من الحدود العملية مع الهياكل الحالية. أظهرت قوانين التدريب التي اكتشفها باحثو OpenAI في عام 2020 أن أداء النموذج يتحسن بشكل يمكن التنبؤ به كلما زادت المعلمات وبيانات التدريب والحساب. لكن تلك القوانين تفترض أن لديك بيانات عالية الجودة بلا حدود. نحن نخرج منها. يحتوي الإنترنت القابل للوصول بالكامل على ربما 10 إلى 50 تريليون كلمة من النص القابل للاستخدام. قامت النماذج المستقبلية بالفعل بالتدريب على أجزاء كبيرة من ذلك النص. لا يمكنك ببساطة تكرار نفس البيانات مرارًا وتكرارًا. النماذج تذكر بدلاً من التعلم. يتزايد الباحثون مع حاجز البيانات، حيث يصبح العثور على مواد تدريبية جديدة عالية الجودة أكثر صعوبة. يقدم البيانات الاصطناعية (محتوى مُنتج من AI مستخدم لتدريب AI آخر) حلًا مغريًا لا يعمل غالبًا. أظهرت التجارب الأولية أن النماذج المدربة على مخرجاتها نفسها تعاني من انهيار النموذج، حيث تتجمع الأخطاء ويتدهور الأداء عبر الأجيال. إنه مثل عمل نسخ ضوئية من نسخ ضوئية: تتدهور الجودة بسرعة. ومع ذلك، يمكن للبيانات الاصطناعية المُنظمة جيدًا أن تعمل للمهام المحددة. يمكنك إنشاء ملايين من مسائل الرياضيات مع حلول موثوقة، أو تحديات الترميز مع اختبارات وحدات تؤكد على الصحة. المفتاح هو وجود التحقق الأوتوماتيكي الذي يلتقط الهلوسات والأخطاء قبل أن تلوث مجموعات التدريب. يعمل هذا النهج للمجالات الهيكلية مثل الرياضيات والشيفرات ولكن يفشل في المهام المفتوحة مثل الكتابة الإبداعية أو التفكير المتعمق حيث لا يمكن التحقق من الصحة الخوارزمي. من المحتمل أن يتضمن مستقبل تعلم الذكاء الاصطناعي بيانات متعددة الوسائط وتجارب مجسدة بدلاً من المزيد من النصوص. يمكن للنماذج التي تتعلم من الفيديو، وبيانات المستشعرات، والبيئات التفاعلية أن تستمر في التحسن لأن تلك المصادر المعطيات تفوق النص في الكم الكبير. يحتوي ساعة واحدة من الفيديو على معلومات أكثر بكثير من ساعات من القراءة. الروبوتات التي تتعلم من خلال التجربة والخطأ في البيئات المحاكاة تولد بيانات تدريب غير محدودة تقريبًا. يتطلب هذا التحول بنية أساسية وتقنيات تدريب جديدة تمامًا، مما يعني أن الجيل الحالي من LLMs (نماذج اللغات الكبيرة) قد يمثل ذروة محلية بدلاً من طريق إلى الذكاء الاصطناعي العام (AGI). نحن لا نتصطدم بسقف على الذكاء الآلي بشكل عام. نحن نتصطدم بسقف على مدى قدرة النماذج اللغوية النقية على الذكاء باستخدام الطرق الحالية ومجموعات البيانات المتاحة.
 💻 technology
لماذا تحرق الذكاء الاصطناعي طاقة كافية لإضاءة مدن صغيرة؟
تتطلب النماذج اللغوية الكبيرة مثل ChatGPT مراكز بيانات ضخمة تستهلك جيجاوات من الكهرباء - وهو ما يكفي لتشغيل أحياء كاملة. السبب ليس الجشع التجاري أو سوء الهندسة. إنها الرياضيات البحتة: تريليونات من العمليات الحسابية في الثانية، مليارات من المعلمات التي يجب التعامل معها، والفيزياء التي تحول الحوسبة إلى حرارة.
رأيي
تتجه صناعة الذكاء الاصطناعي إلى أزمة طاقة ترفض الاعتراف بها علنًا. يتحدث التنفيذيون في التكنولوجيا بلا نهاية عن أمان الذكاء الاصطناعي ومحاذاته بينما يتجاهلون الفيل الموجود في غرفة الخادم: إبداعاتهم هي كوارث بيئية على نطاق صناعي. نحن نبني أدمغة رقمية تستهلك طاقة تعادل طاقة دول صغيرة لتخبرك بكيفية كتابة البريد الإلكتروني وتلخيص المقالات. لا يضيف التحليل التكلفة والفائدة، ولا يريد أي أحد أن يقولها بصوت عالٍ. الفضيحة الحقيقية ليست أن LLMs تحتاج إلى الكثير من القوة - تلك هي الفيزياء. الفضيحة هي أن الشركات تتسرع في وضع هذه النماذج في كل مكان دون محادثات صادقة حول التبادلات الطاقوية. هل يحتاج كل موقع ويب إلى روبوت دردشة ذكي اصطناعي؟ هل يحتاج كل هاتف ذكي إلى معالجة الذكاء الاصطناعي على الجهاز؟ نحن نقوم بأتمتة المهام التي أداها البشر بشكل جيد بتكلفة طاقة لا تذكر، ثم نهنئ أنفسنا على الابتكار. في حين أن المرافق تقوم بتشغيل محطات الفحم المتقاعدة لتلبية طلب مراكز بيانات الذكاء الاصطناعي. هذا ليس تقدمًا. هذا هو الإدمان المتنكر في شكل تقدم. يتطلب الطريق إلى الأمام صدقًا قاسيًا حول التطبيقات الذكاء الاصطناعي التي تبرر تكلفتها الطاقوية. التشخيص الطبي، البحوث العلمية، النمذجة المناخية - ربما تتجاوز تلك العتبة. توليد نسخ التسويق والمحتوى الترفيهي؟ ربما لا. حتى تبدأ الصناعة في نشر بيانات استهلاك الطاقة في الوقت الفعلي وقبول حدود صارمة على النمو، فإننا نبني فقط طريقة أكثر تعقيدًا لغلي الكوكب.
ماذا سيحدث بعد ذلك
في غضون 18 شهرًا، سنرى أولى إلغاءات المشاريع الذكاء الاصطناعي الكبرى بسبب قيود سعة الشبكة، وليس بسبب فشل تقني. سيعلن مزود سحابة كبير، غالبًا في فيرجينيا أو أيرلندا أو سنغافورة، عن تأخيرات في التوسع لأن المرافق لا يمكنها ببساطة توفير ما يكفي من الطاقة. لن يصفها الشركة كمشكلة طاقة؛ سيطلقون عليها تسمية إعادة التموضع الاستراتيجية أو التحديات التنظيمية. لكن الوثائق الداخلية ستخبر الحقيقة: الشبكة بلغت حدودها. تصبح الطاقة النووية البطل الغير متوقع في قصة الذكاء الاصطناعي، ولكن ليس بالطريقة التي يتخيلها المتفائلون بالتكنولوجيا. لن تنقذ المفاعلات المعيارية الصغيرة اليوم لأنها لا تزال بعيدة عن الانتشار التجاري على نطاق واسع. بدلًا من ذلك، ستعيد الشركات القديمة تشغيل محطات نووية مهجورة خصيصًا لعقود التكنولوجيا. بعد صفقة مايكروسوفت مع جزيرة الثلاثة أميال، توقع إعلانات مماثلة من أمازون وجوجل بحلول أوائل 2027. سيواجه البيئيون خيارًا مستحيلًا: دعم الطاقة النووية من أجل الذكاء الاصطناعي، أو مشاهدة محطات الفحم تعود إلى العمل. سيتحمل معظمهم ذلك ويقبلون النووي كشر قليل. السيناريو الغير متوقع الذي لا يقدر بثمن: تكاليف الطاقة تطلق نهضة في أبحاث كفاءة الخوارزميات التي تعمل بالفعل. حاليًا، تقوم الشركات بتوسيع النماذج لأنه أسهل من جعلها أذكى لكل معلمة. ولكن إذا أصبحت الطاقة هي العامل المحدد - إذا بدأت المرافق بفرض أسعار من 3 إلى 5 أضعاف للشركات الذكاء الاصطناعي أثناء أوقات الطلب العالي - فجأة هناك حافز مالي هائل لبناء نماذج تعمل مثل GPT 4 باستخدام مستويات الحساب لـ GPT 3. قد نرى تقنيات ضغط اختراق، طرق نادرة لتفعيل المعلمات ذات الصلة فقط، أو بنى جديدة تمامًا تتخلى عن نهج القوة الغاشمة لنموذج المحولات. قد تضطر الأزمة إلى الابتكار الذي منعت الوفرة.
ما يخبرنا به التاريخ
مسار الطاقة لصناعة الذكاء الاصطناعي يشبه تصاعد تعدين العملات المشفرة بين عامي 2017 و2021، مع ديناميات مرعبة مشابهة. استهلكت مزارع تعدين البيتكوين في ذروتها حوالي 150 تيراواط ساعة سنويًا - أكثر من أمم بأكملها مثل الأرجنتين. لاحق المعدّنون الكهرباء الرخيصة إلى المناطق النائية، وتجاوزوا الشبكات المحلية، وأثاروا ردود فعل سلبية من المجتمعات التي تواجه انقطاع التيار الكهربائي وزيادة الأسعار. في النهاية، حظرت الصين التعدين في عام 2021، جزئيًا بسبب مخاوف الطاقة. الآن، تقيد عدة ولايات في الولايات المتحدة عمليات التعدين الجديدة. يمتد التشابه إلى ما يتجاوز الأرقام. وعدت كلتا التقنيتين بفوائد ثورية بينما نقلت تكاليف الطاقة إلى الشبكات العامة ودافعي الضرائب. أصرت كلتا الصناعتين على أن تحسين الكفاءة سيحل المشكلة (لم يفعلا - التضخم تجاوز مكاسب الكفاءة). تسببت كلتاهما في نقص عالمي في الأجهزة حيث تنافست الشركات للحصول على رقائق متخصصة. الفرق الرئيسي: أن الذكاء الاصطناعي يتمتع بدعم مؤسسي وسياسي أوسع من الذي حققه التشفير على الإطلاق، مما يجعل القيود التنظيمية أقل احتمالًا رغم الطلبات المتزايدة للطاقة المقارنة. تشير التاريخ إلى أن أزمات الطاقة المدفوعة بالتكنولوجيا لا تحل عبر تقييد تطوعي للصناعة - تنتهي عن طريق قيود الموارد أو التدخل التنظيمي أو تقدم التكنولوجيا.
تأثير السوق
تتداول NVIDIA حول 900-950 دولارًا للسهم اعتبارًا من مايو 2026، مع تسعير بالفعل لطلب هائل على البنية التحتية للذكاء الاصطناعي - لكن حكاية قيود الطاقة قد تحد من مزيد من الارتفاع. إذا بدأت المرافق في رفض طلبات توسيع مراكز البيانات، فإن الطلب على رقائق H100 والرقائق المستقبلية سوف يثبت أسرع مما يتوقع المحللون. التفاؤل قصير الأجل (6-12 شهرًا) حيث تُستكمل المشاريع الحالية، ولكن راقب علامات من دفع الطلبات من المشغلين الكبار. يعتبر Vistra Energy وConstellation Energy اللاعبين المفاجئين في مجال الطاقة AI. كلاهما يملك أصول نووية ويتفاوضان بنشاط مع عمالقة التكنولوجيا. أرسلت صفقة Constellation مع جزيرة الثلاثة أميال أسهمها بارتفاع 20% عندما أُعلنت. عندما تصبح شركات الذكاء الاصطناعي يائسة للحصول على مصادر طاقة خاصة، توقع من المرافق التي تملك قدرة نووية أن تفرض أسعارًا متميزة. طويلة الأمد على VST وCEG. يواجه ناسداك الأوسع خطرًا لم يتحدث عنه أحد. إذا أجبرت قيود الطاقة شركات الذكاء الاصطناعي على إبطاء النشر أو تقليل أحجام النموذج، فإن العلاوة التقييمية المستندة إلى الذكاء الاصطناعي لقطاع التكنولوجيا بأكمله تتبخر. نحن نتحدث عن تصحيحات محتملة من 15-20% في MSFT وGOOGL وMETA وAMZN إذا تغيرت الروايات من "AI في كل مكان" إلى "AI فقط حيث يسمح الطاقة." هذا ليس خطرًا لعام 2026 - إنه خطر لعامي 2027-2028 مع تقدم قيود البنية التحتية.