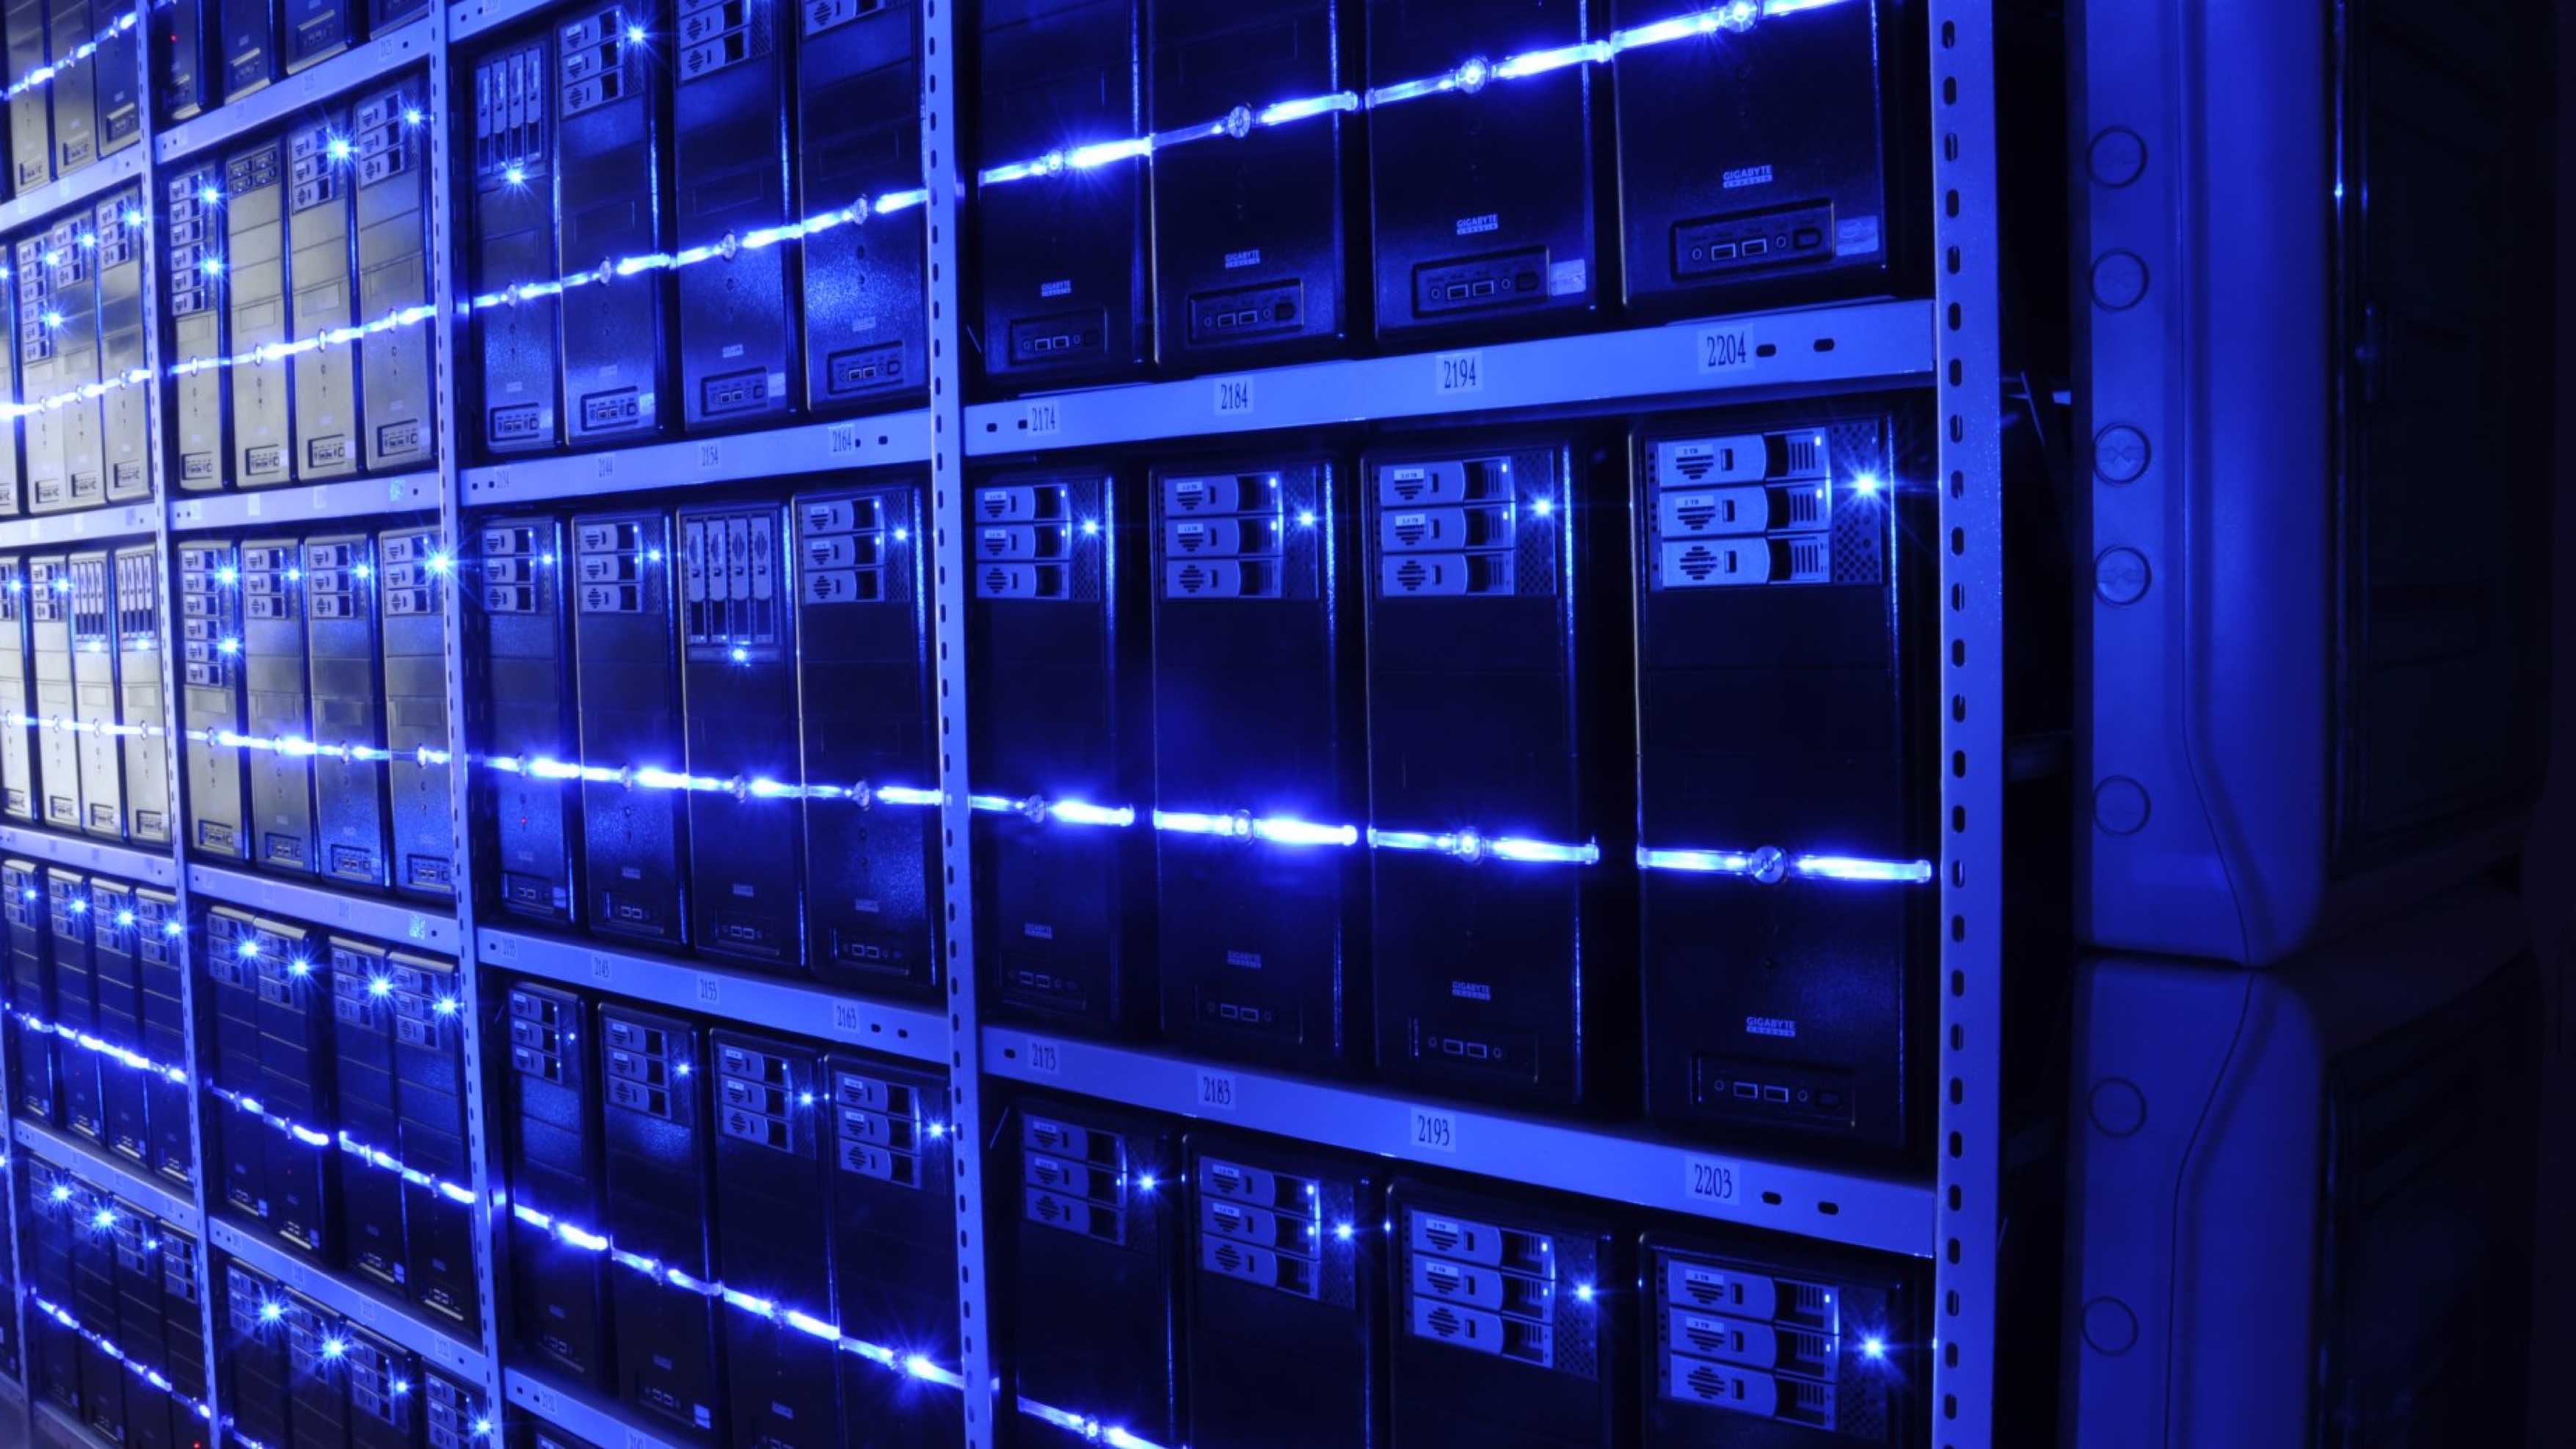
Commençons par ce qui se passe réellement lorsque vous posez une question à ChatGPT. Votre simple demande déclenche des milliards d'opérations mathématiques à travers des milliers de puces spécialisées appelées GPU (unité de traitement graphique). Ces puces ne stockent pas seulement le modèle d'IA, elles calculent activement les probabilités pour chaque mot possible suivant, croisent les schémas des données d'entraînement représentant des fragments de l'ensemble de l'internet, et affinent les prédictions à travers des couches de réseaux neuronaux. Chaque couche ajoute du poids computationnel. On dit que GPT 4 a plus d'un trillion de paramètres. Pensez à ces paramètres comme des boutons que l'IA ajuste pour générer des réponses cohérentes. Chaque bouton a besoin de puissance pour fonctionner. Avant que tout cela ne se produise, votre requête passe par un processus appelé tokenisation. Lorsque vous tapez "Comment sont conçus les LLMs ?" dans ChatGPT, votre navigateur n'envoie pas ce texte brut aux serveurs d'OpenAI. Au lieu de cela, JavaScript en cours d'exécution sur votre ordinateur local décompose la phrase en tokens, qui sont des morceaux de texte que le modèle comprend. Un token peut être un mot entier comme "Comment," ou un morceau de mot comme "conç" et "us" séparés. Le tokenizer convertit votre phrase en une séquence de chiffres, chacun représentant un token spécifique du vocabulaire du modèle (qui compte généralement entre 50 000 et 100 000 tokens possibles). Ces chiffres, et non votre texte original, sont transmis au centre de données. Cela se produit instantanément, en millisecondes, et utilise une puissance négligeable sur votre appareil. Une fois que votre requête tokenisée arrive au centre de données, elle frappe un répartiteur de charge, un ordinateur spécialisé qui décide quel serveur doit traiter votre demande. Les principaux fournisseurs d'IA exploitent plusieurs centres de données sur différents continents, donc votre requête pourrait être dirigée vers la Virginie, l'Oregon, l'Irlande ou Singapour en fonction de la proximité géographique et de la charge actuelle du serveur. Le rôle du répartiteur de charge est de prévenir la surcharge d'une machine tout en gardant les autres inactives. Il suit quels serveurs sont occupés, lesquels ont de la capacité, et distribue les requêtes entrantes en conséquence. Cette décision de routage se fait en microsecondes. Votre requête est ensuite assignée à un serveur d'inférence spécifique, qui pourrait être une seule machine physique avec 8 GPU, ou plus probablement, un ensemble de machines travaillant ensemble. C'est là que la complexité explose. Le modèle d'IA est trop grand pour tenir sur un seul GPU. Les plus de 1 trillion de paramètres de GPT 4 nécessitent des centaines de gigaoctets de mémoire. Un seul GPU H100 dispose de 80 gigaoctets de mémoire à haute bande passante (HBM). Ainsi, le modèle est divisé sur plusieurs GPU en utilisant une technique appelée parallélisme de modèle. Différentes couches du réseau neuronal résident sur différentes puces. Lors du traitement de votre demande, les GPU doivent constamment communiquer entre eux, transmettant les résultats intermédiaires d'une couche à l'autre. Ces GPU communiquent via des interconnexions à haute vitesse spécialisées, pas un Ethernet régulier. La technologie NVLink de NVIDIA permet aux GPU du même serveur de transférer des données à 900 gigaoctets par seconde, environ 10 fois plus rapide que les SSD grand public les plus rapides. Pour les GPU dans différents serveurs, les centres de données utilisent des réseaux InfiniBand, qui offrent des vitesses similaires avec une latence extrêmement faible (ordre de la microseconde). Cela est crucial car le modèle d'IA traite votre demande de manière séquentielle, un token à la fois. Le premier GPU traite les calculs de la première couche, envoie les résultats au deuxième GPU pour la deuxième couche, et ainsi de suite à travers potentiellement 96 couches ou plus. Tout retard de communication devient un goulet d'étranglement qui ralentit le temps de réponse. Voici la partie que la plupart des gens ne réalisent pas : ces GPU ne traitent pas seulement votre requête. Ils en traitent des dizaines ou des centaines simultanément grâce à une technique appelée batching. Le serveur regroupe les requêtes de différents utilisateurs arrivées à peu près en même temps, les traite en parallèle sur les mêmes cœurs de GPU, puis divise les résultats. Cela améliore considérablement l'efficacité. Un GPU calculant une seule réponse à la fois gâche la plupart de ses cœurs de traitement. Regrouper plusieurs requêtes ensemble occupe tous les cœurs. Cependant, le regroupement complique la communication inter GPU. Les résultats pour différents utilisateurs doivent rester séparés, nécessitant une gestion de la mémoire supplémentaire et un routage des données soigneux. La réalité physique du calcul crée un problème inévitable : l'électricité devient de la chaleur. Les puces modernes d'IA comme les GPU H100 de NVIDIA consomment 700 watts chacune sous pleine charge, soit environ autant que sept anciennes ampoules à incandescence fonctionnant simultanément. Mais les centres de données n'abritent pas sept GPU. Ils en abritent des milliers ou des dizaines de milliers. Le SuperCluster de Recherche IA de Meta utilise 16 000 GPU. Les installations de Microsoft soutenant OpenAI en utilisent apparemment bien plus. Lorsque vous multipliez 700 watts par 20 000 GPU, vous obtenez 14 mégawatts rien que pour le calcul, avant même le refroidissement, le réseau ou le stockage. C'est assez pour alimenter environ 10 000 foyers américains. Le refroidissement devient le vampire énergétique caché. Ces GPU génèrent une chaleur énorme dans des racks de serveurs emballés. Sans refroidissement agressif, les puces surchauffent et échouent en quelques minutes. Les centres de données utilisent des systèmes de climatisation à l'échelle industrielle, des systèmes de refroidissement liquide, et parfois un refroidissement par évaporation qui consomme des millions de gallons d'eau chaque année. Les centres de données de Google ont utilisé 4,3 milliards de gallons d'eau rien qu'en 2022. L'infrastructure de refroidissement consomme souvent 30 à 40% de la puissance autant que le calcul lui-même. La physique ne négocie pas. La chaleur doit être éliminée à la vitesse à laquelle elle est générée, ou le matériel fond. Pourquoi ne peuvent-ils pas utiliser de modèles plus petits ? Parce que la performance se dégrade de manière catastrophique. La recherche montre que les modèles plus grands avec plus de paramètres démontrent des capacités émergentes, des capacités que les modèles plus petits ne peuvent tout simplement pas reproduire, peu importe le temps d'entraînement. GPT 3 avec 175 milliards de paramètres fonctionne beaucoup mieux que les modèles avec 1 milliard de paramètres sur les tâches de raisonnement complexes. Il n'y a pas d'astuce d'efficacité pour contourner cela. Vous voulez que l'IA comprenne le contexte, génère des réponses créatives et évite des résultats insensés ? Vous payez le prix des paramètres. Plus de paramètres signifient plus de calcul par requête, ce qui signifie plus d'énergie. Mais cela n'a pas toujours été ainsi. Le premier grand modèle de langage qui a vraiment choqué les chercheurs et le public était GPT 2, publié par OpenAI en février 2019. Le modèle avait 1,5 milliard de paramètres, minuscule selon les standards actuels, mais révolutionnaire pour son temps. OpenAI a initialement refusé de publier le modèle complet, invoquant des préoccupations de sécurité concernant une mauvaise utilisation potentielle pour générer de fausses nouvelles et du spam. Cette décision elle-même est devenue un moment charnière, la première fois qu'un laboratoire d'IA a publiquement affirmé que leur technologie était trop dangereuse pour être partagée librement. La démonstration originale de GPT 2 était remarquablement simple et fonctionnait sur un matériel modeste. Les chercheurs d'OpenAI montraient au modèle une demande comme "Dans une découverte choquante, un scientifique a découvert un troupeau de licornes vivant dans une vallée reculée, jusqu'alors inexplorée, dans les montagnes des Andes." Le modèle poursuivait alors l'histoire avec plusieurs paragraphes cohérents sur les licornes, leurs manteaux blancs argentés, leurs cornes uniques aux propriétés curatives, et l'émerveillement des scientifiques face à cette découverte. Le texte s'écoulait naturellement, maintenait des détails cohérents, et inventait même des noms de scientifiques et des institutions de recherche plausibles. Les lecteurs ne pouvaient pas immédiatement dire qu'il était généré par une machine. Ce qui rendait cette démonstration puissante n'était pas les exigences matérielles, c'était la percée conceptuelle. GPT 2 a prouvé qu'un seul modèle, formé uniquement pour prédire le mot suivant dans une séquence, pouvait apparemment comprendre la structure narrative, maintenir le contexte sur plusieurs centaines de mots, et générer de la fiction créative sans aucune programmation spécifique à la tâche. Les systèmes d'IA précédents avaient besoin de modules séparés pour différentes tâches : un pour la traduction, un autre pour la synthèse, un troisième pour répondre aux questions. GPT 2 a tout fait avec une architecture, simplement en apprenant des schémas dans le texte. Les exigences en calcul pour cette première démonstration étaient modestes selon les standards des centres de données. GPT 2 pouvait fonctionner (générer du texte) sur un seul GPU grand public haut de gamme, quelque chose qu'un chercheur bien équipé pourrait avoir dans son poste de travail de bureau. Un NVIDIA GTX 1080 Ti avec 11 gigaoctets de mémoire pouvait gérer la variante GPT 2 la plus grande, générant du texte à quelques mots par seconde. Le fichier modèle lui-même pesait environ 6 gigaoctets. Vous pouviez le télécharger, le charger en mémoire, et commencer à générer du texte sans avoir besoin de ressources cloud. Cette accessibilité était cruciale. Les chercheurs du monde entier pouvaient expérimenter avec GPT 2, repousser ses limites, et découvrir à la fois ses capacités et ses échecs. L'entraînement de GPT 2, cependant, était une autre histoire. OpenAI a utilisé 40 gigaoctets de texte internet et l'a formé sur un réseau de machines pendant des semaines. Même en 2019, cela nécessitait des ressources computationnelles significatives, probablement des centaines de milliers de dollars en coûts de cloud computing. Mais c'était réalisable pour un laboratoire bien financé, pas encore les projets de millions de dollars que l'entraînement de GPT 4 exigerait. Andrej Karpathy, ancien directeur de l'IA chez Tesla et chercheur chez OpenAI, a ensuite démontré la simplicité fondamentale des modèles de langage avec un projet d'enseignement appelé "minGPT." Il a montré que vous pouvez implémenter un modèle GPT fonctionnel avec quelques centaines de lignes de code Python. L'architecture n'est pas magique, c'est de la multiplication de matrices et des mécanismes d'attention, des opérations standard que tout étudiant diplômé en informatique peut comprendre. Ce qui a changé entre GPT 2 et GPT 4 n'était pas l'algorithme fondamental. C'était l'échelle : plus de paramètres, plus de données d'entraînement, plus de calcul et, crucial, plus d'énergie. Le moment GPA 2 a été le "hello world" de l'IA parce qu'il a prouvé que la modélisation du langage fonctionnait à une échelle qui comptait. Les modèles précédents généraient des âneries grammaticalement correctes ou mémorisaient les données d'entraînement sans comprendre. GPT 2 montrait quelque chose qui ressemblait à de la compréhension, même si philosophiquement, il ne faisait que prédire des schémas statistiques. Les chercheurs lui ont donné des suggestions en français et ont obtenu des réponses cohérentes en français, malgré l'absence d'entraînement explicite pour la traduction. Ils lui ont demandé d'écrire des poèmes dans des styles spécifiques et ont obtenu des tentatives plausibles. Le modèle n'était pas parfait, il finissait par dévier du sujet ou se contredire, mais les capacités étaient indéniables. La stratégie de sortie progressive d'OpenAI a ajouté à l'impact de GPT 2. Ils ont d'abord publié une version plus petite de 124 millions de paramètres, puis progressivement des variantes plus grandes au cours des mois suivants, alors que la communauté de recherche démontrait une utilisation responsable. Cela a créé une attention soutenue et a donné aux chercheurs le temps d'explorer les capacités de chaque taille. Au moment où la version complète de 1,5 milliard de paramètres est sortie en novembre 2019, la communauté IA avait passé neuf mois à découvrir ce que les modèles de langage à grande échelle pouvaient faire. Ce travail préparatoire a fait que l'annonce de GPT 3 en juin 2020 a semblé une évolution naturelle plutôt qu'un choc. GPT 3 a changé la donne parce qu'OpenAI n'a pas publié le modèle à télécharger. Au lieu de cela, ils ont offert un accès API, où les développeurs envoyaient des demandes aux serveurs d'OpenAI et recevaient des complétions. Ce changement était crucial pour deux raisons : il protégeait l'avantage concurrentiel d'OpenAI (personne ne pouvait étudier ou copier leur modèle directement), et il centralisait les exigences en matière de calcul. Soudainement, vous n'aviez plus besoin de GPU pour utiliser GPT 3. Vous aviez juste besoin d'une clé API et d'une carte de crédit. Cela a démocratisé l'accès tout en créant une dépendance à l'infrastructure d'OpenAI. Le modèle API signifiait également que les utilisateurs ne voyaient jamais le coût réel en calcul. Lorsque vous exécutiez GPT 2 sur votre machine locale, vous entendiez les ventilateurs monter en régime, ressentiez la chaleur, peut-être remarquiez votre facture d'électricité augmenter si vous l'exécutiez constamment. Avec l'API de GPT 3, le calcul se faisait invisiblement dans un centre de données quelque part. Vous payiez par token, quelques centimes pour des milliers de mots, sans avoir conscience des mégawatts consommés en coulisses. Cette abstraction est la façon dont l'industrie s'est développée si rapidement sans déclencher immédiatement des préoccupations énergétiques. Les coûts étaient cachés dans les budgets opérationnels et les factures d'utilité, pas visibles pour les utilisateurs finaux. Voici maintenant la distinction cruciale que la plupart des gens manquent : utiliser un modèle d'IA entraîné (inférence) est complètement différent de former le modèle d'IA en premier lieu. Lorsque vous discutez avec ChatGPT, vous utilisez un modèle déjà formé. L'entraînement est ce qui s'est passé des mois plus tôt, lorsque OpenAI a créé ce modèle à partir de zéro. Pensez-y comme la différence entre lire un livre et écrire le livre. Utiliser ChatGPT, c'est lire. L'entraînement est le processus difficile d'écrire chaque mot. L'entraînement commence avec une ardoise vierge, un réseau neuronal avec des valeurs de paramètres aléatoires qui produit des âneries complètes. Imaginez des milliards de boutons tous réglés sur des positions aléatoires. Le réseau ne sait rien de la langue, de la grammaire, des faits ou du raisonnement. C'est du charabia numérique. Le processus d'entraînement consiste à ajuster ces milliards de boutons, petites quantités à la fois, jusqu'à ce que le réseau commence à produire du texte cohérent. Voici comment ça fonctionne réellement : Vous nourrissez le réseau avec un énorme morceau de texte, disons un article Wikipédia sur les dauphins. Le réseau essaie de prédire le prochain mot dans une phrase. Avec des paramètres aléatoires, il échoue spectaculairement. Là où le vrai texte dit "Les dauphins sont des mammifères marins très intelligents," le réseau non entraîné pourrait prédire "Les dauphins sont violets dix sept basket" parce que ses paramètres sont absurdes. L'algorithme d'entraînement mesure à quel point cette prédiction était erronée. Cela s'appelle calculer la perte. Plus la prédiction est incorrecte, plus le chiffre de la perte est élevé. Vient alors l'étape clé : la rétropropagation. L'algorithme travaille à reculons à travers toutes les couches du réseau, calculant exactement combien chacun de ces milliards de paramètres a contribué à la prédiction terrible. C'est comme la comptabilité judiciaire pour les réseaux neuronaux, retraçant l'erreur jusqu'à ses sources. Une fois que l'algorithme sait quels paramètres ont causé le problème, il les ajuste légèrement dans la direction qui aurait produit une meilleure prédiction. C'est ce qu'on appelle la descente de gradient. Vous ajustez des milliards de boutons, chacun d'eux un peu, en essayant de vous rapprocher pas à pas d'une meilleure performance. Un ajustement ne fait pas grand chose. Mais vous répétez ce processus des trillions de fois, avec des trillions d'exemples de texte différents, et peu à peu ces boutons aléatoires se déplacent vers des configurations qui fonctionnent réellement. La consommation d'énergie pour l'entraînement est absolument stupéfiante parce que vous faites ce calcul de manière répétée à travers l'ensemble du texte disponible sur internet. On estime que l'entraînement de GPT 3 a nécessité 1,287 mégawattheures, l'équivalent de ce que 120 foyers américains utilisent en une année entière, brûlés en semaines ou mois de calcul continu. Vous ne faites pas que lire du texte. Vous faites des quadrillions d'opérations mathématiques : multiplications de matrices, calculs de gradients, mises à jour de paramètres, tout cela à travers des milliers de GPU fonctionnant 24/7. Voici pourquoi l'entraînement est bien plus cher que l'inférence : Lorsque vous utilisez ChatGPT (inférence), les paramètres sont figés. Le réseau effectue une traversée en avant de ses couches, calcule des probabilités, choisit un mot, et passe à autre chose. L'entraînement nécessite une traversée en avant pour faire une prédiction, puis une traversée en arrière pour calculer les gradients, ensuite des mises à jour de paramètres, puis des vérifications de validation, tout cela répété des milliards de fois. Vous faites peut-être 100 fois plus de calculs par mot pendant l'entraînement que pendant l'inférence. L'entraînement moderne se déroule aussi en plusieurs phases. D'abord, il y a le pré-entraînement, où le modèle apprend des schémas de langage généraux à partir de vastes ensembles de données. C'est la partie coûteuse qui consomme plus de 1 000 mégawattheures. Ensuite, vient la fine-tuning, où vous prenez ce modèle pré-entraîné et le spécialisez pour des tâches spécifiques comme suivre des instructions ou avoir des conversations. La fine-tuning utilise des ensembles de données plus petits et soigneusement sélectionnés et ajuste les paramètres plus doucement. Cela reste coûteux en termes de calcul, mais peut-être 1 à 10% du coût du pré-entraînement. Les entreprises font aussi de l'apprentissage par renforcement à partir de feedback humain (RLHF), où des évaluateurs humains scorent les réponses de l'IA, et l'algorithme d'entraînement ajuste les paramètres pour produire des réponses qui obtiennent des scores plus élevés. Cela ajoute une autre couche de coût d'entraînement parce que vous avez besoin d'humains dans la boucle, générant du feedback, qui ensuite alimente plus de descente de gradient et de mises à jour de paramètres. Une fois l'entraînement terminé, vous avez un fichier modèle contenant des milliards de valeurs de paramètres figés. Ce fichier est copié sur des serveurs d'inférence dans le monde entier. Ces serveurs lisent simplement les paramètres et les utilisent pour répondre aux questions. Ils ne modifient jamais les paramètres. Le modèle reste exactement aussi intelligent (ou stupide) qu'il l'était au moment où l'entraînement s'est terminé. Utiliser ChatGPT un milliard de fois ne le rend pas plus intelligent, car l'inférence ne change pas les paramètres. C'est un point critique que beaucoup de gens ne comprennent pas : les modèles d'IA n'apprennent pas des conversations avec les utilisateurs. Ce sont des instantanés statiques de connaissances figées à la fin de leur processus d'entraînement. C'est pourquoi le fantasme du Raspberry Pi ne fonctionne pas. Vous pouvez télécharger un modèle pré-entraîné sur votre Pi et faire de l'inférence, mais le Pi ne rendra jamais ce modèle plus intelligent par son utilisation. L'entraînement nécessite du matériel spécialisé, des ensembles de données massifs, et des mois de calcul qu'un Pi mettrait des siècles à compléter. Le modèle que vous avez téléchargé est figé dans le temps, un instantané de ce qu'il a appris pendant l'entraînement. Pourquoi Claude surpasse-t-il souvent ChatGPT dans les tâches de codage ? La réponse n'est pas simplement plus de données. C'est quelles données, comment elles sont pondérées, et comment le modèle est affiné après l'entraînement initial. Anthropic a formé Claude avec une technique appelée AI Constitutionnelle (CAI), qui implique de multiples tours de raffinement où l'IA critique et révise ses propres productions basées sur des principes explicites. Pour le codage spécifiquement, cela signifie que Claude a probablement vu plus d'exemples de code diversifiés pendant l'entraînement, a reçu des signaux plus forts pour donner la priorité à la précision plutôt qu'à la créativité, et a subi un apprentissage par renforcement supplémentaire spécifiquement sur des défis de programmation. OpenAI et Anthropic utilisent des ensembles de données d'entraînement différents avec des stratégies de licence et de sourcing différentes. Claude a peut-être ingéré plus de dépôts GitHub, de discussions Stack Overflow, et de documentation technique. L'architecture du modèle diffère également légèrement. Bien que les deux utilisent des conceptions basées sur les transformateurs, les choix d'Anthropic concernant les mécanismes d'attention, l'optimisation des fenêtres de contexte, et la gestion du texte structuré par rapport au texte non structuré peuvent affecter considérablement la performance sur des tâches nécessitant une syntaxe et une logique précises. Le principe de la qualité sur la quantité est d'une énorme importance dans les données d'entraînement. Nourrir un modèle d'IA de 10 billions de tokens de texte internet aléatoire produit de pires résultats que 5 billions de tokens soigneusement sélectionnés. Pour les tâches de codage, cela signifie donner la priorité aux dépôts avec du code bien commenté, de qualité production, par rapport aux devoirs d'étudiants extraits de forums. Cela signifie pondérer plus fortement la documentation technique et les références API que les blogs occasionnels sur le codage. Anthropic a probablement consacré un effort d'ingénierie significatif à filtrer les données d'entraînement pour l'excellence en codage, tandis qu'OpenAI a optimisé GPT 4 plus largement pour la capacité conversationnelle, l'écriture créative, et les connaissances générales. Aucune des deux approches n'est mauvaise, mais elles produisent des modèles avec des forces différentes. Y a-t-il un plafond à l'apprentissage de l'IA, ou les modèles peuvent-ils simplement continuer à s'améliorer indéfiniment ? La réponse honnête : nous ne savons pas encore, mais les preuves suggèrent que nous approchons des limites pratiques avec les architectures actuelles. Les lois de l'échelle découvertes par les chercheurs d'OpenAI en 2020 ont montré que la performance des modèles s'améliore de manière prévisible à mesure que vous augmentez les paramètres, les données d'entraînement, et le calcul. Mais ces lois supposent que vous avez des données de haute qualité illimitées. Nous arrivons au bout. L'internet accessible tout entier contient peut-être de 10 à 50 billions de mots de texte utilisable. Les modèles de pointe ont déjà été entraînés sur une grande partie de ce corpus. Vous ne pouvez pas simplement faire tourner les mêmes données en boucle. Les modèles mémorisent plutôt qu'ils n'apprennent. Les chercheurs frappent le mur des données, où il devient exponentiellement plus difficile de trouver du matériel d'entraînement frais et de haute qualité. Les données synthétiques (contenu généré par IA utilisé pour entraîner d'autres IA) offrent une solution tentante qui ne fonctionne généralement pas. Les premières expériences ont montré que les modèles entraînés sur leurs propres résultats subissent un effondrement du modèle, où les erreurs s'accumulent et la performance se dégrade au fil des générations. C'est comme faire des photocopies de photocopies : la qualité se détériore rapidement. Cependant, des données synthétiques soigneusement sélectionnées peuvent fonctionner pour des tâches spécifiques. Vous pouvez générer des millions de problèmes de maths avec des solutions vérifiées, ou des défis de codage avec des tests unitaires confirmant la justesse. La clé est d'avoir une vérification automatisée qui attrape les hallucinations et les erreurs avant qu'elles n'empoisonnent l'ensemble d'entraînement. Cette approche fonctionne pour les domaines structurés comme les maths et le code, mais échoue pour les tâches ouvertes comme l'écriture créative ou le raisonnement nuancé, où la justesse n'est pas vérifiable de manière algorithmique. L'avenir de l'apprentissage de l'IA implique probablement des données multimodales et une expérience incarnée plutôt que plus de texte. Les modèles qui apprennent à partir de vidéos, de données de capteurs, et d'environnements interactifs peuvent continuer à s'améliorer, car ces sources de données dominent le texte en volume pur. Une seule heure de vidéo contient bien plus d'informations que des heures de lecture. Les robots qui apprennent par essai et erreur dans des environnements simulés génèrent des données d'entraînement effectivement illimitées. Ce changement nécessite des architectures et des techniques d'entraînement fondamentalement différentes, ce qui signifie que la génération actuelle de LLM textuels (grands modèles de langage) peut représenter un maximum local plutôt qu'un chemin vers l'intelligence générale artificielle (AGI). Nous ne touchons pas un plafond sur l'intelligence machine au sens large. Nous touchons un plafond sur la façon dont les modèles de langage pur peuvent devenir plus intelligents en utilisant les méthodes courantes et les données textuelles disponibles.
 💻 technology
Pourquoi l'IA Consomme Assez d'Énergie pour Éclairer de Petites Villes
Les grands modèles de langage comme ChatGPT nécessitent d'énormes centres de données qui consomment des gigawatts d'électricité - assez pour alimenter des quartiers entiers. La raison n'est ni la cupidité des entreprises ni une mauvaise ingénierie. C'est simplement mathématique : des trillions de calculs par seconde, des milliards de paramètres à gérer, et la physique qui transforme le calcul en chaleur.
Mon avis
L'industrie de l'IA avance somnambuliquement vers une crise énergétique qu'elle refuse de reconnaître publiquement. Les responsables technologiques parlent sans fin de la sécurité et de l'alignement de l'IA tout en ignorant l'éléphant dans la salle des serveurs : leurs créations sont des désastres environnementaux à une échelle industrielle. Nous construisons des cerveaux numériques qui consomment autant d'énergie que de petites nations pour vous dire comment écrire des e-mails et résumer des articles. L'analyse du rapport coût-bénéfice ne tient pas la route, et personne ne veut le dire à voix haute. Le véritable scandale n'est pas que les LLM nécessitent beaucoup d'énergie, c'est la physique. Le scandale est que les entreprises s'empressent de placer ces modèles partout sans discussions honnêtes sur les compromis énergétiques. Chaque site web a-t-il besoin d'un chatbot AI ? Chaque smartphone a-t-il besoin de traitement AI intégré ? Nous automatisons des tâches que les humains réalisaient parfaitement bien avec un coût énergétique négligeable, puis nous nous félicitons pour l'innovation. Pendant ce temps, les services publics rallument des centrales à charbon retirées du service pour répondre à la demande des centres de données AI. Ce n'est pas du progrès. C'est une addiction déguisée en avance. La voie à suivre nécessite une honnêteté brutale sur les applications de l'IA qui justifient leur coût énergétique. Diagnostic médical, recherche scientifique, modélisation climatique, ces domaines pourraient justifier la barre. Générer du contenu publicitaire et des divertissements sans valeur ? Probablement pas. Jusqu'à ce que l'industrie commence à publier des données de consommation énergétique en temps réel et accepter des limites strictes sur la croissance, nous construisons simplement un moyen plus élaboré de faire bouillir la planète.
Et ensuite ?
Dans les 18 mois, nous verrons les premières annulations majeures de projets d'IA en raison de contraintes de capacité du réseau, pas de défaillances techniques. Un grand fournisseur de cloud probablement en Virginie, en Irlande ou à Singapour annoncera des retards d'expansion car les services publics ne peuvent littéralement pas fournir suffisamment de puissance. La compagnie ne l'encadrera pas comme un problème énergétique ; ils appelleront cela un repositionnement stratégique ou un défi réglementaire. Mais les documents internes diront la vérité : le réseau a atteint sa capacité maximum. Le nucléaire devient le héros improbable de l'histoire de l'IA, mais pas comme les techno-optimistes l'imaginent. Les petits réacteurs modulaires (SMRs) ne sauveront pas la mise parce qu'ils sont encore à des années d'une mise en œuvre commerciale à grande échelle. Au lieu de cela, les services publics traditionnels relanceront des centrales nucléaires mises en veille spécifiquement pour des contrats technologiques. Après l'accord de Three Mile Island de Microsoft, attendez-vous à des annonces similaires d'Amazon et Google d'ici début 2027. Les environnementalistes seront confrontés à un choix impossible : soutenir l'énergie nucléaire pour l'IA, ou voir les centrales à charbon redémarrer. La plupart se boucheront le nez et accepteront le nucléaire comme le moindre mal. Le scénario joker que personne n'a pris en compte : les coûts énergétiques déclenchent une renaissance de la recherche sur l'efficacité algorithmique qui fonctionne réellement. Actuellement, les entreprises augmentent l'échelle des modèles parce que c'est plus facile que de les rendre plus intelligents par paramètre. Mais si l'énergie devient le facteur limitant si les services publics commencent à facturer les entreprises d'IA 3 5 fois les tarifs normaux pendant les pics de demande, alors soudain il y a un énorme incitatif financier pour construire des modèles qui fonctionnent comme GPT 4 en utilisant les niveaux de calcul de GPT 3. Nous pourrions voir des techniques de compression révolutionnaires, des méthodes de parcimonie qui activent uniquement les paramètres pertinents, ou des architectures entièrement nouvelles qui abandonnent l'approche brutale du modèle transformateur. La crise pourrait forcer l'innovation que l'abondance a empêchée.
Ce que l'histoire nous apprend
La trajectoire énergétique de l'industrie de l'IA reflète le boom de l'exploitation minière des cryptomonnaies de 2017 à 2021, avec des dynamiques étrangement similaires. Les fermes de minage de Bitcoin consommaient environ 150 térawattheures par an à leur apogée, plus que des pays entiers comme l'Argentine. Les mineurs recherchaient l'électricité bon marché dans des régions reculées, submergeaient les réseaux locaux, et provoquaient des réactions de communautés confrontées à des coupures et à la hausse des tarifs. La Chine a finalement interdit le minage en 2021, en partie à cause des préoccupations énergétiques. Plusieurs États américains restreignent maintenant les nouvelles opérations de minage. Le parallèle va au-delà des chiffres. Les deux technologies ont promis des bénéfices révolutionnaires tout en externalisant les coûts énergétiques sur les réseaux publics et les payeurs de tarifs. Les deux industries ont insisté sur le fait que les améliorations d'efficacité résoudraient le problème (elles n'ont pas, l'échelle a dépassé les gains d'efficacité). Les deux ont déclenché une pénurie mondiale de matériel alors que les entreprises se disputaient des puces spécialisées. La différence clé : l'IA bénéficie d'un soutien corporatif et politique beaucoup plus large que le crypto n'en a jamais atteint, rendant les restrictions réglementaires moins probables malgré des demandes énergétiques comparables. L'histoire suggère que les crises énergétiques entraînées par la technologie ne se résolvent pas par une retenue volontaire de l'industrie elles se terminent à travers des contraintes de ressources, une intervention réglementaire, ou une obsolescence technologique.
Impact sur les marches
NVIDIA se négocie autour de 900 à 950 dollars par action en mai 2026, intégrant déjà une demande massive d'infrastructure AI mais le récit de contrainte énergétique pourrait limiter une nouvelle hausse. Si les services publics commencent à rejeter les demandes d'expansion des centres de données, la demande pour les puces H100 et les futures puces Blackwell plafonne plus rapidement que les analystes ne l'attendent. Optimiste à court terme (6 à 12 mois) alors que les projets existants s'achèvent, mais surveillez les signes de reports de commandes des hyperscalers. Vistra Energy et Constellation Energy sont la surprise en matière de puissance AI. Les deux possèdent des actifs nucléaires et négocient activement des contrats avec des géants de la technologie. L'accord de Constellation pour Three Mile Island a fait grimper son action de 20 % à l'annonce. Comme les entreprises d'IA deviennent désespérées pour des sources d'énergie dédiées, attendez-vous à ce que les services publics avec une capacité nucléaire imposent des tarifs premium. Long sur VST et CEG. Le NASDAQ plus large fait face à un risque de surplomb que personne ne discute. Si les contraintes énergétiques forcent les entreprises d'IA à ralentir le déploiement ou à réduire la taille des modèles, la prime d'évaluation de la tech sector liée à l'IA s'évapore. Nous parlons potentiellement de corrections de 15 à 20 % pour MSFT, GOOGL, META et AMZN si les récits de croissance passent de "l'IA partout" à "l'IA seulement là où l'énergie le permet." Ce n'est pas un risque pour 2026 c'est un risque pour 2027-2028 alors que les contraintes d'infrastructure mordent.